

一句话结论
NVIDIA 在北京 GTC 展示面向欧洲市场的本地 AI 硬件集群与优化模型,大幅提升智能体开发效率。
关键要点
- NVIDIA 于 10 月 16 日发布 RTX Spark 个人工作站,具备最高 128GB 统一内存,提供 1 Petaflop AI 算力,并支持 1440p 100 帧的高帧率游戏体验。
- DGX Spark 64GB 系统自 10 月 23 日起通过合作伙伴出货,可在单台设备上运行 Nemotron 3.5 Bolt 74B(24GB 显存需求)及 Qwen3.8 27B 等大参数本地模型。
- DGX Station 提供 748GB 相干内存及最高 20 Petaflops AI 性能,能同时服务 30 余名用户,其 Windows 版本预计于 12 月由多家硬件厂商正式发货。
- NVIDIA 新增对 Nemotron Bolt E4B、GLM、DeepSeek、Qwen 及 FLUX.3 Klein 等多款前沿模型的支持,并在 llama.cpp 与 vLLM 中引入推测解码技术以加速推理。
- 开发者可利用 NeMo AutoModel 工具进行后训练,针对特定本地硬件优化的模型检查点可显著降低运行所需内存阈值。
背景与事实
在 2024 年的 GTC 柏林大会上,NVIDIA 全面展示了其面向欧洲市场的本地人工智能硬件阵容。此次展示的核心在于构建从个人开发者到企业级研究团队的完整算力链条。旗舰产品 RTX Spark 于 10 月 16 日正式发布,该平台专为 Windows 个人智能体应用设计,不仅拥有高达 1 Petaflop 的 AI 算力,还配备了最高 128GB 的统一内存,足以支持 1440p 分辨率下 100 帧的高性能图形渲染,实现了游戏与本地大模型运行的资源平衡。
面向企业级与科研场景,DGX 系列产品进行了重要更新。DGX Spark 64GB 系统已在 10 月 23 日起通过包括戴尔、惠普等合作伙伴渠道出货,其架构支持运行 Nemotron 3.5 Bolt 74B(需 24GB 显存)、Qwen3.8 27B 以及 Gemma 4 26B-A4B 等复杂模型。DGX Station 则提供了更强大的集群能力,配备 748GB 相干内存,算力峰值达到 20 Petaflops,能够同时满足 30 多名开发者的高负载需求。该系统支持通过 ConnectX-7 网络将最多 8 台 DGX Spark 节点连接,形成 1TB 统一内存池,从而支撑 GLM 5.3 等前沿模型的本地化部署。
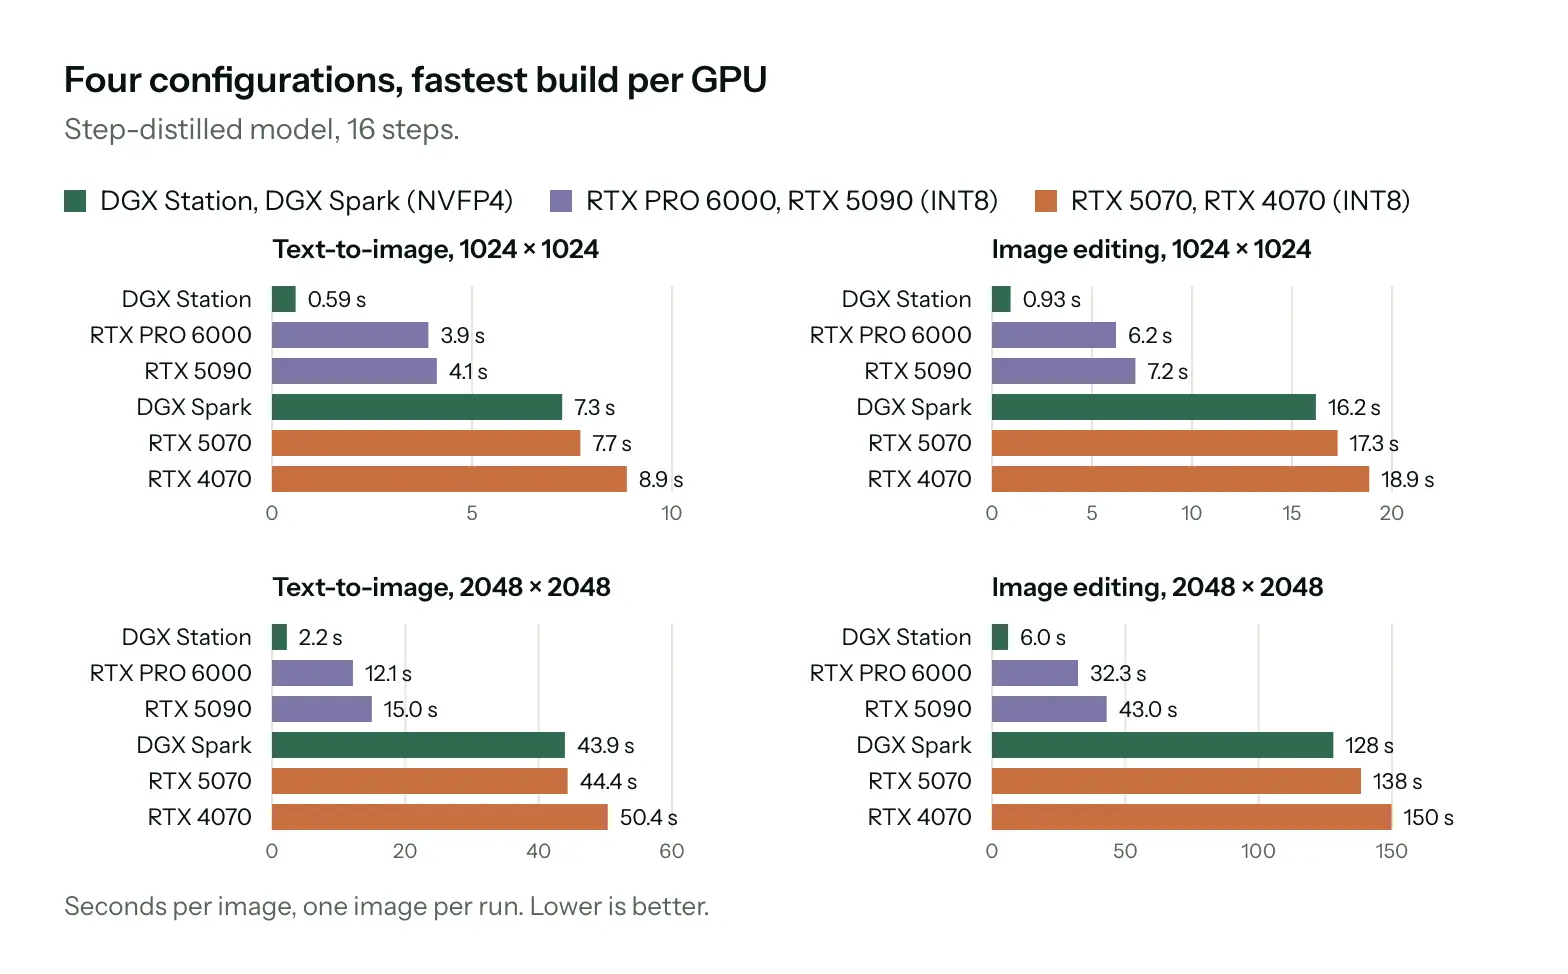
模型生态方面,NVIDIA 扩大了其本地 AI 库的支持范围。新增支持的模型包括 Nemotron Bolt E4B(4GB 内存需求,10 月 23 日发布)、GLM、DeepSeek、Qwen、MiniMax、Liquid AI LFM2.5-24B-A2B 以及 FLUX.3 Klein。其中,FLUX 3 Image Klein 是一款拥有 56 亿参数的开放权重模型,在配备 8GB 显存的 RTX GPU 上生成 100 万像素图像耗时约 4 秒。此外,第三方机构 Recursive Superintelligence 推出的 Recursive Flint 模型(400 亿参数混合专家,激活参数 25 亿)在 64GB RTX Spark 上的推理速度超过 220 词/秒,且基于 Apache 2.0 协议开放权重。
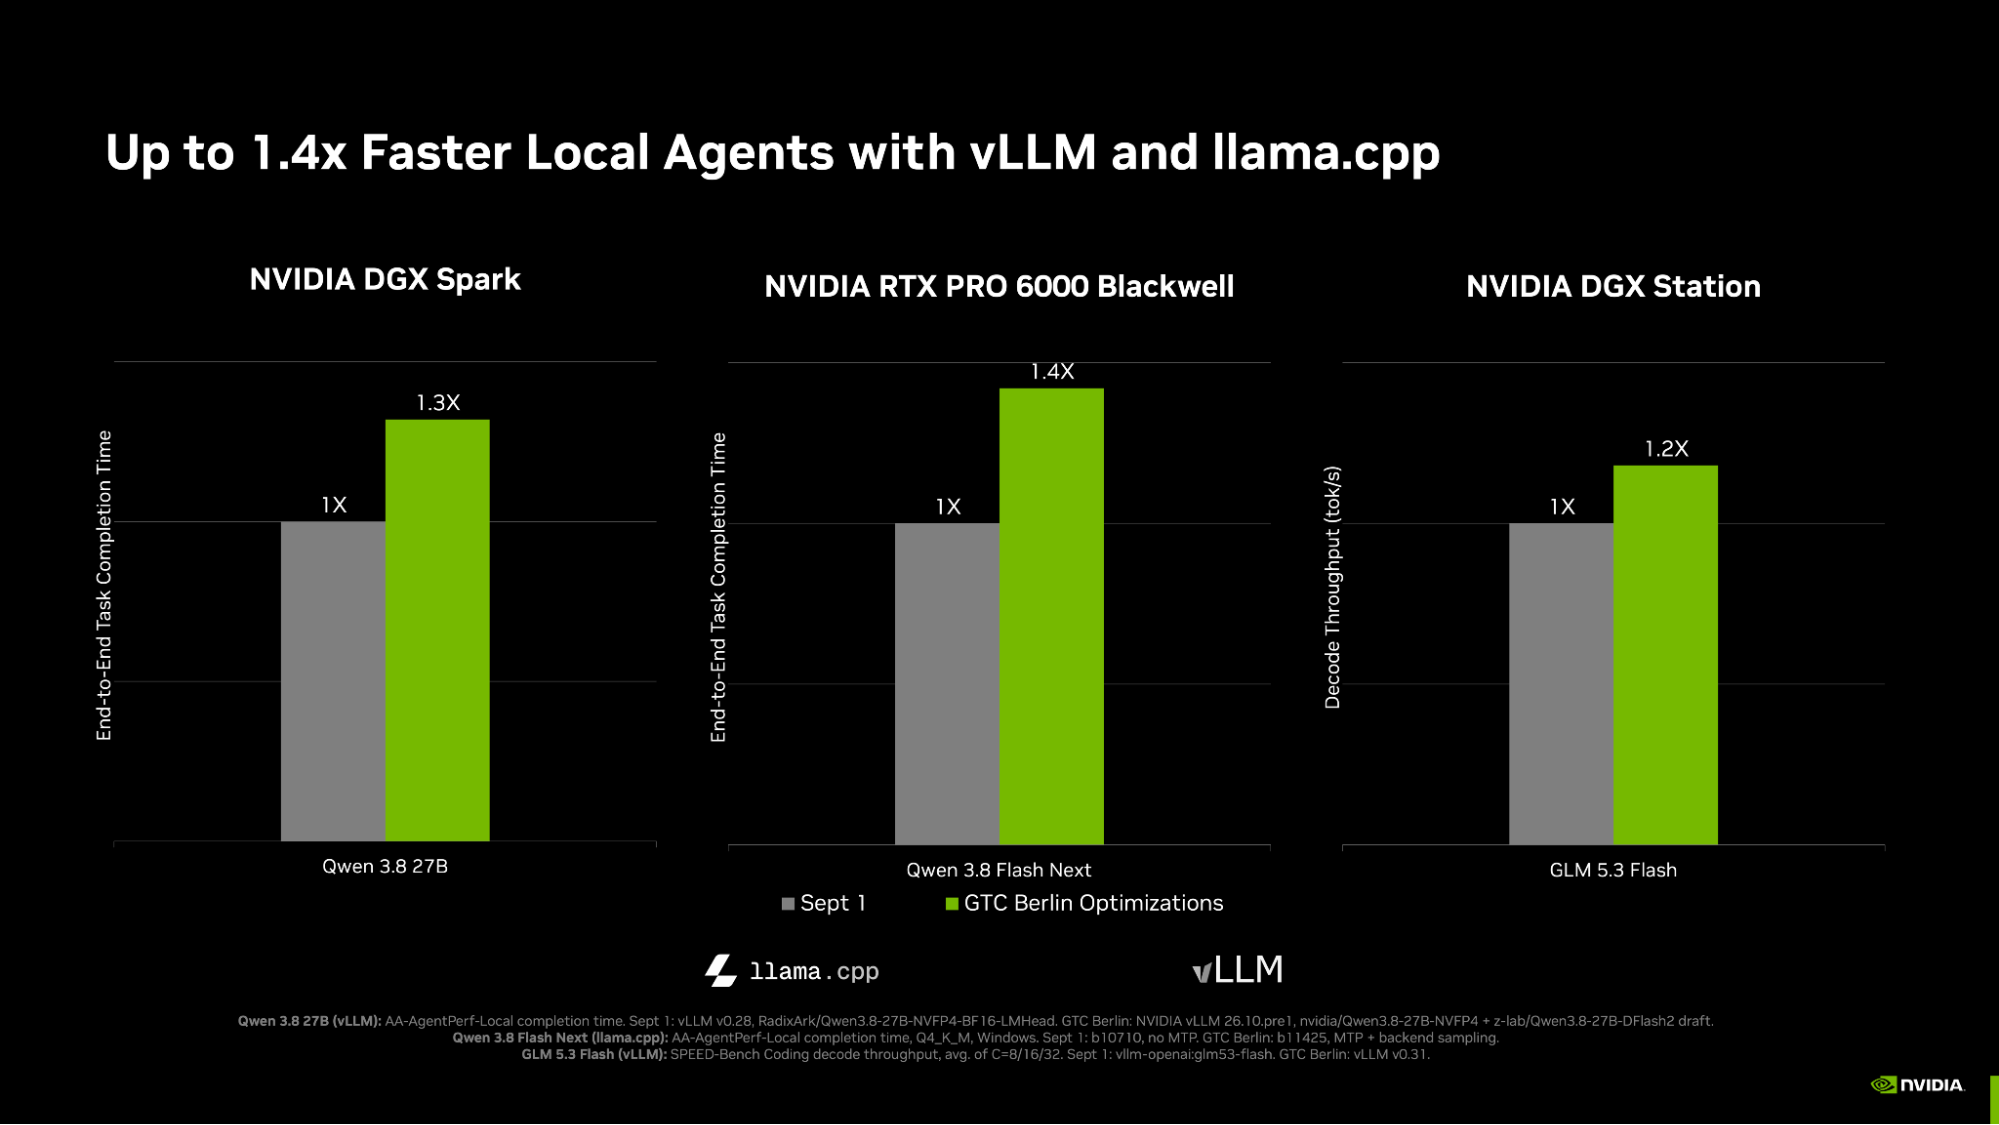
在软件工具链上,NVIDIA 重点优化了推理性能。在 llama.cpp 框架中,新增了对 Qwen 3.8 Flash Next 的多 token 预测推测解码支持,使基于 NVIDIA RTX PRO 6000 Blackwell 的端到端智能体任务速度最高提升 1.4 倍。在 vLLM 框架中,针对 Qwen 线性注意力层引入新的 FlashInfer 预填充内核,结合更快的推测解码,使得 DGX Spark 上 Qwen3.8 27B 智能体任务速度最高提升 1.3 倍,DGX Station 上 GLM 5.3 Flash 的吞吐量最高提升 1.2 倍。
影响分析
对中文开发者及国内科技从业者而言,这一系列更新具有显著的工程实践价值。NVIDIA 明确将 GLM、DeepSeek、Qwen 和 MiniMax 等中国头部实验室的最新模型纳入其硬件加速支持列表,意味着国内开发者在使用国产模型时,无需进行复杂的底层适配,即可直接获得针对 DGX 或 RTX 系列的特定优化检查点,例如 Qwen3.8-Flash-Next-FP4-Local。这种“开箱即用”的性能提升(如吞吐量最高 1.2 倍至 1.4 倍的优化)直接降低了本地部署大模型的研发门槛与硬件成本。
此外,DGX 系列对 1TB 统一内存池的支持,使得在本地私有化环境中运行 GLM 5.3 等参数量较大的前沿模型成为可能,这对于对数据隐私有严格要求的金融、医疗及法律行业从业者尤为重要。NVIDIA 提供 NeMo AutoModel 进行后训练的能力,结合 748GB 相干内存的 DGX Station,进一步巩固了本地算力在垂直领域微调环节的优势,使得团队能够在不依赖云端算力的情况下完成从预训练模型到垂直应用定制的全流程闭环。
适用边界
本分析结论基于 NVIDIA 针对特定硬件(如 64GB/128GB 内存版本)及特定软件栈(llama.cpp, vLLM)的优化场景。若开发者使用的是非 NVIDIA 架构显卡,或未更新至支持推测解码的最新软件版本,上述提到的 1.2 倍至 1.4 倍性能提升将不成立。DGX Station 的高内存优势仅适用于需要同时服务 30 名以上并发用户的集群环境;对于单人或小规模团队,DGX Station 的硬件冗余可能导致资源闲置,性价比低于 DGX Spark。此外,Windows 版本的 DGX Station 尚未完全铺开(预计 12 月出货),目前主要功能集中于 Linux 环境,因此主要适用于以 Linux 为开发标准的工程团队,纯 Windows 本地化部署场景需等待后续更新。
孤本观察
编辑观察到,NVIDIA 此次策略的核心不仅是销售硬件,而是通过提供针对中国模型(GLM, Qwen等)的本地量化优化版本,将欧洲及全球开发者锁定在 NVIDIA 的算力护城河内。这是典型的“软件定义硬件”策略,通过降低跨语言、跨框架的集成成本,利用模型生态绑定硬件市场。
常见问题
RTX Spark个人工作站具备的最高统一内存容量和AI算力是多少?
RTX Spark个人工作站具备最高128GB统一内存,提供1 Petaflop AI算力。
DGX Spark 64GB系统自何时起通过合作伙伴出货?
DGX Spark 64GB系统自10月23日起通过合作伙伴出货。
DGX Station能同时服务多少名用户?其Windows版本预计何时发货?
DGX Station能同时服务30余名用户,其Windows版本预计于12月由多家硬件厂商正式发货。
FLUX 3 Image Klein在8GB显存RTX GPU上生成100万像素图像耗时多久?
FLUX 3 Image Klein在配备8GB显存的RTX GPU上生成100万像素图像耗时约4秒。
使用DGX Station的1TB统一内存池支持对哪些行业从业者尤为重要?
对对数据隐私有严格要求的金融、医疗及法律行业从业者尤为重要。
来源:NVIDIA Blog