

一句话结论
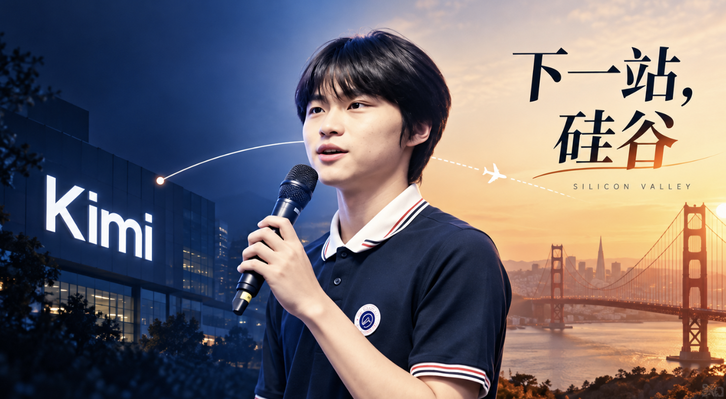
17岁研究者陈广宇离职 Kimi 团队,确认将前往美国旧金山湾区,否认加入 Anthropic。
关键要点
- 陈广宇于 10 月 15 日在 X 上宣布离开月之暗面(Moonshot AI),将前往旧金山湾区。
- 他明确否认了加入 Anthropic 参与 Claude 研发的传闻,下一家雇主、职位及入职时间尚未披露。
- 陈广宇是 Attention Residuals 论文的共同第一作者,参与了 Kimi K3 大语言模型的扩展与预训练工作。
- 他在 Tilde Research 期间参与了 MoMoE 项目,优化了混合专家模型的内存占用与计算效率。
- 陈广宇 2026 年从惠州华润小径湾贝赛思国际学校高中毕业,17 岁时在 AI 领域已有多项研究成果。
背景与事实
10 月 15 日,17 岁的陈广宇(nathan chen)在 X 平台上宣布离开月之暗面(Moonshot AI),确认将前往美国旧金山湾区。他在声明中将过去一年在 Kimi 的经历描述为“迄今人生中最美好的时光”,并特别感谢团队在他 16 岁时给予参与核心研究的机会。此次离职消息公布后,AI 社区迅速展开讨论,主要焦点集中在陈广宇的下一站去向。
在陈广宇的声明评论区,Anthropic 研究员 Sholto Douglas 留言祝贺,并邀请他前往旧金山与 Prime/Base10 团队共事。这一互动被部分网友解读为暗示陈广宇将加入 Anthropic,但陈广宇在随后的回复中明确表示并非如此。截至发稿,陈广宇的下一家雇主、具体职位及入职时间均未公开,外界对其去向仍属猜测阶段。
回顾陈广宇的研究轨迹,他在 Kimi 团队实习期间主要投身于大语言模型扩展与预训练工作,重点参与 Kimi K3 的模型架构与优化器研究,同时关注适配硬件的高效算法与计算内核开发。在加入 Kimi 之前,他曾于 Tilde Research 从事应用可解释性研究,参与 MoMoE(Memory-optimized Mixture of Experts)项目,该研究通过融合 Triton 内核与优化内存布局,解决了混合专家模型在训练和微调过程中的显存占用与计算效率问题。
陈广宇最受瞩目的成果是 2026 年 3 月 16 日公开的《Attention Residuals》(《注意力残差》)论文。他与张宇、苏剑林共同担任第一作者,提出使用跨层 softmax 注意力替代 PreNorm Transformer 中的固定权重累加,使模型能够根据输入选择性地聚合早期层的表示。该设计在总参数 480 亿、激活参数 30 亿的 Kimi Linear 架构上得到验证,预训练数据规模达 1.4 万亿 token,实验表明 Block AttnRes 可达到需多用 25% 计算量的基线模型损失水平。此外,他在 Kimi 团队期间还参与了 Kimi Delta Attention(KDA)计算内核的加速工作。
影响分析
陈广宇的离职与去向选择对中文开发者与从业者具有显著的参考意义。作为 17 岁即参与大模型核心架构研究的年轻研究者,他的经历展示了在 AI 领域快速成长并产出高质量研究成果的可行性路径。从行业视角看,这一案例反映出大模型研发中底层优化(如计算内核、内存管理)的重要性日益提升,年轻研究者在硬件适配与算法效率方面的贡献愈发关键。
对于中文技术社区而言,陈广宇的研究成果具有直接的工程参考价值。Attention Residuals 提出的跨层注意力机制为模型扩展提供了新的架构思路,MoMoE 项目在混合专家模型优化方面的实践也为相关开发者提供了可复现的工程方案。尽管他即将离开国内团队,但其已公开的研究成果与代码实现仍可供中文开发者学习与借鉴。
适用边界
需要明确的是,本文所涉及的结论仅适用于陈广宇个人研究轨迹与当前离职事件的描述。Attention Residuals 的实验数据基于 Kimi Linear 特定架构(总参数 480 亿、激活参数 30 亿),其“Block AttnRes 可达到需多用 25% 计算量的基线模型损失水平”的结论不能直接推广至所有模型架构与训练条件。MoMoE 项目的优化方案针对混合专家模型,对密集模型或其他架构的适用性需另行评估。陈广宇尚未披露的具体去向与入职时间,属于未来事件,不构成当前事实。
孤本观察
从陈广宇的研究轨迹来看,17 岁即从阅读经典论文、编写计算内核起步,逐步参与大模型架构设计与底层优化,展现了快速积累与跨界融合的研究能力。这一案例表明,在 AI 研发领域,年轻研究者通过聚焦硬件适配与算法效率等底层问题,能够较快产出具有工程价值的研究成果,其成长路径对中文技术社区中具有潜力的年轻开发者具有启示意义。


常见问题
陈广宇在哪一天宣布离职,并确认将前往美国的哪个地区?
陈广宇于10月15日在X平台上宣布离开月之暗面,并确认将前往美国旧金山湾区。
陈广宇是否确认加入了Anthropic参与Claude研发?
陈广宇明确否认了加入Anthropic参与Claude研发的传闻,截至发稿时其下一家雇主尚未披露。
《Attention Residuals》论文在Kimi Linear架构上的验证规模及效果如何?
该论文在总参数480亿、激活参数30亿的Kimi Linear架构上验证,预训练数据达1.4万亿token,Block AttnRes可达到需多用25%计算量的基线模型损失水平。
MoMoE项目优化了混合专家模型的哪些性能指标?
MoMoE项目通过融合Triton内核与优化内存布局,解决了混合专家模型在训练和微调过程中的显存占用与计算效率问题。
陈广宇是哪一年毕业的?毕业前在AI领域有哪些主要研究参与?
陈广宇2026年从惠州华润小径湾贝赛思国际学校高中毕业,17岁时已参与Kimi K3模型架构研究与MoMoE项目优化。
来源:InfoQ 中文 AI