
一句话结论
谷歌发布两款基于现有芯片的新系统TPU 8tx与TPU 8i Max,一年内出货四款TPU系统,将硬件拓展为面向外部客户的推理平台。
关键要点
- 谷歌在第八代TPU产品线中新增TPU 8tx与TPU 8i Max两款系统,二者均基于现有处理器构建,而非全新一代芯片。
- TPU 8tx专为机密数据设计,支持在数据处理期间保持数据与模型权重加密与隔离。
- TPU 8i Max通过在同一封装上集成两枚TPU 8i芯片,在同一机架内实现计算性能、内存容量和内存带宽翻倍。
- 谷歌开源了TorchTPU,使PyTorch代码可近乎无改动地运行于TPU,并支持vLLM、SGLang等主流推理框架。
- 谷歌目前拥有近100家外部TPU客户,战略重心从内部使用转向对外市场竞争。
背景与事实
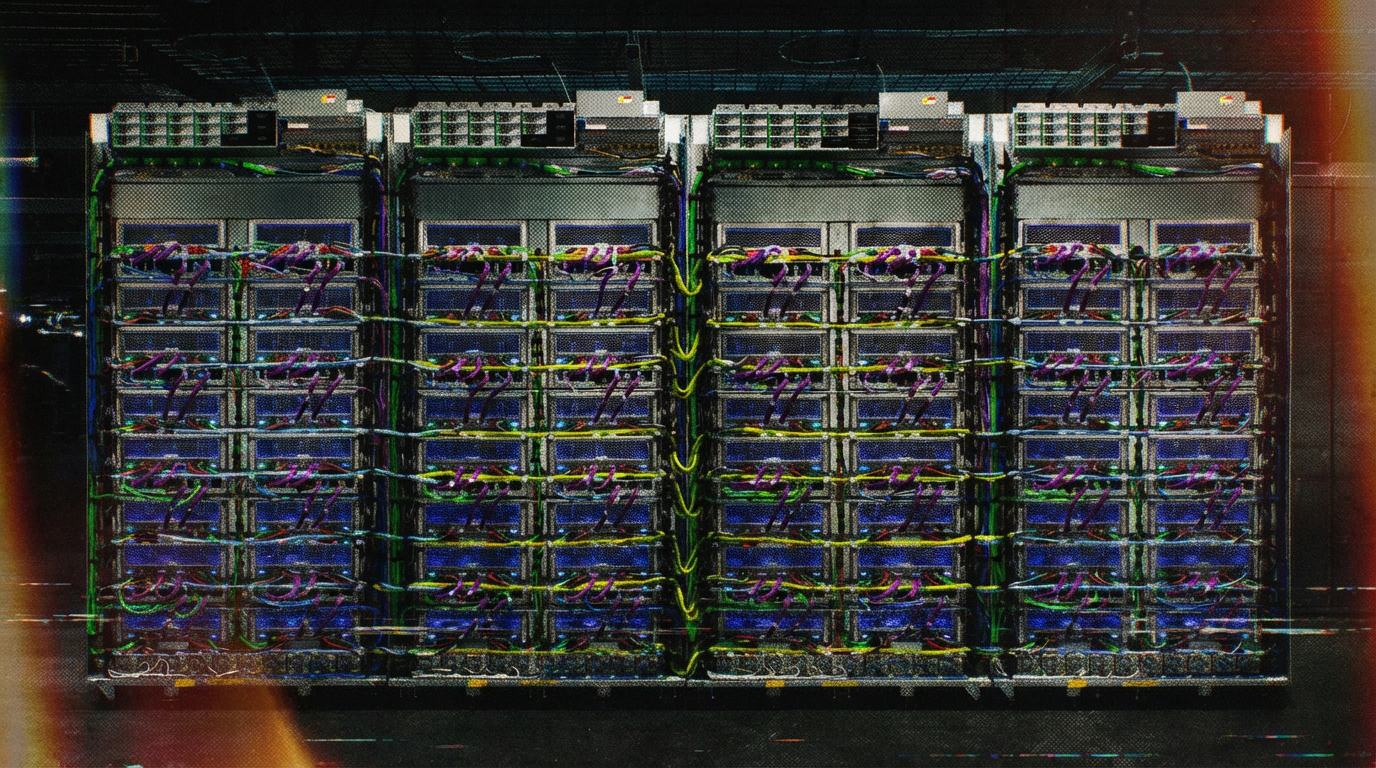
谷歌在第八代AI加速器产品线中新增两款系统:面向机密计算场景的TPU 8tx,以及面向内存密集型负载的TPU 8i Max。这两款新品使谷歌在一年内首次出货四款TPU系统。值得注意的是,这两款新品并非基于全新芯片世代,而是围绕同一代处理器进行系统级配置创新,包括不同的封装形式、网络拓扑与内存架构。谷歌将这种模块化路径定位为主动设计选择,使其能够在数月而非数年内交付新的硬件变体。
TPU 8tx瞄准企业与政府机构处理敏感数据的场景。通常数据在存储与传输阶段加密,但在处理器实际运算时必须在内存中解密。TPU 8tx旨在消除这一安全缺口:根据谷歌官方说明,数据与模型权重在活跃使用期间始终受到保护且相互隔离。该系统采用谷歌为实时推理开发的低延迟Boardfly网络,据称相比TPU 8t可实现最高两倍的延迟降低。企业可在单一系统上完成模型微调、将大模型蒸馏为小模型以及基于强化学习训练AI Agent,且无需在多个集群之间搬运敏感数据。英伟达已在其GPU的机密计算架构中提供类似能力。
TPU 8i Max解决的是另一个核心瓶颈:内存带宽。当AI Agent并行处理大型代码库或数小时视频时,内存带宽成为性能瓶颈。谷歌的方案是在单一封装上放置两枚TPU 8i芯片,从而在同一机架规格内实现计算性能翻倍、内存容量翻倍、内存带宽翻倍,显著提升每平方米数据中心空间的性能密度。
在软件生态层面,谷歌开源了TorchTPU,让PyTorch代码可在TPU上以最小改动运行,同时支持vLLM、SGLang等主流推理框架。此外,谷歌目前拥有近100家外部TPU客户,其战略方向已从将TPU作为纯内部工具,转变为将其打造为面向外部客户的竞争性硬件平台。
影响分析
对中文开发者与从业者而言,这一动向释放出两个明确信号。第一,大模型日常推理正在取代一次性训练成为芯片竞争的核心赛道。随着AI应用大规模落地,推理端对延迟、内存带宽与单位面积性能的需求持续攀升,谷歌以系统级配置创新快速迭代的做法,为国内芯片厂商提供了参考路径:在制程或算力代际差距尚未完全弥合的前提下,可通过封装创新、网络拓扑与内存架构优化,以月为单位缩短交付周期。第二,机密计算能力正成为企业级AI基础设施的标配需求。TPU 8tx将数据与权重在运算期间保持加密隔离,这意味着国内面向政企市场的大模型部署方案需同步规划机密计算硬件支持,否则在金融、医疗、政务等强合规场景中将面临部署门槛。TorchTPU的开源也降低了切换成本,PyTorch用户迁移至TPU的摩擦减小,对国内推理服务供应商在硬件选型时多出一个务实选项。
适用边界
上述结论存在明确边界。TPU 8tx与TPU 8i Max均基于谷歌现有硅片,并非全新架构,其性能提升主要来自系统级配置而非制程突破,在绝对算力天花板层面不构成代际跨越。TorchTPU支持PyTorch代码"最小改动运行",但复杂算子、自定义CUDA核函数及针对特定框架的深度优化在TPU上仍可能存在兼容性缺口,并非所有工作负载均可直接迁移。机密计算功能针对的是谷歌TPU生态,不适用于英伟达GPU或其他国产芯片的已有部署。此外,近100家外部客户的数据为谷歌官方口径,客户实际部署规模、工作负载类型与续约率均未披露,不宜据此推断TPU在外部市场的实际渗透深度。
孤本观察
谷歌以"同芯不同配"策略在一年内出货四款TPU系统的做法,本质上是在用系统工程替代制程竞赛,这一判断基于来源中明确指出新品基于现有处理器而非新世代芯片的事实。


常见问题
TPU 8tx 和 TPU 8i Max 是基于全新芯片还是现有处理器?
这两款新品均基于谷歌现有处理器构建,并非全新一代芯片,而是通过系统级配置创新(如封装形式、网络拓扑与内存架构)实现性能提升。
TPU 8i Max 如何实现计算性能翻倍?
通过在同一封装上集成两枚 TPU 8i 芯片,从而在同一机架内实现计算性能、内存容量和内存带宽的翻倍。
谷歌开源了哪些软件工具来支持 TPU 生态?
谷歌开源了 TorchTPU,使 PyTorch 代码可近乎无改动运行于 TPU,并支持 vLLM、SGLang 等主流推理框架。
TPU 8tx 在延迟方面相比 TPU 8t 有何表现?
TPU 8tx 采用低延迟 Boardfly 网络,据称相比 TPU 8t 可实现最高两倍的延迟降低,旨在消除数据处理期间的安全缺口。
谷歌目前有多少家外部 TPU 客户?
谷歌目前拥有近 100 家外部 TPU 客户,战略重心已从内部使用转向对外市场竞争,但具体部署规模与续约率未披露。
来源:The Decoder