

一句话结论
谷歌发布两款Gemini 3.8 TTS模型,支持2000余种音色与30秒音频自定义克隆,大幅降低多角色语音合成门槛。
关键要点
- 谷歌于2026年9月23日发布两款模型:gemini-3.8-flash-tts与gemini-3.8-flash-lite-tts,两者均提供超过2000种预设音色。
- 用户仅需提供30秒的音频样本(可为本人声音或已获授权的声音),即可创建自定义语音模型,无需长篇录音。
- gemini-3.8-flash-tts生成1分18秒多角色对话音频耗时约20秒,成本仅0.0274美元(约2.74美分),非低价版Flash-Lite模型。
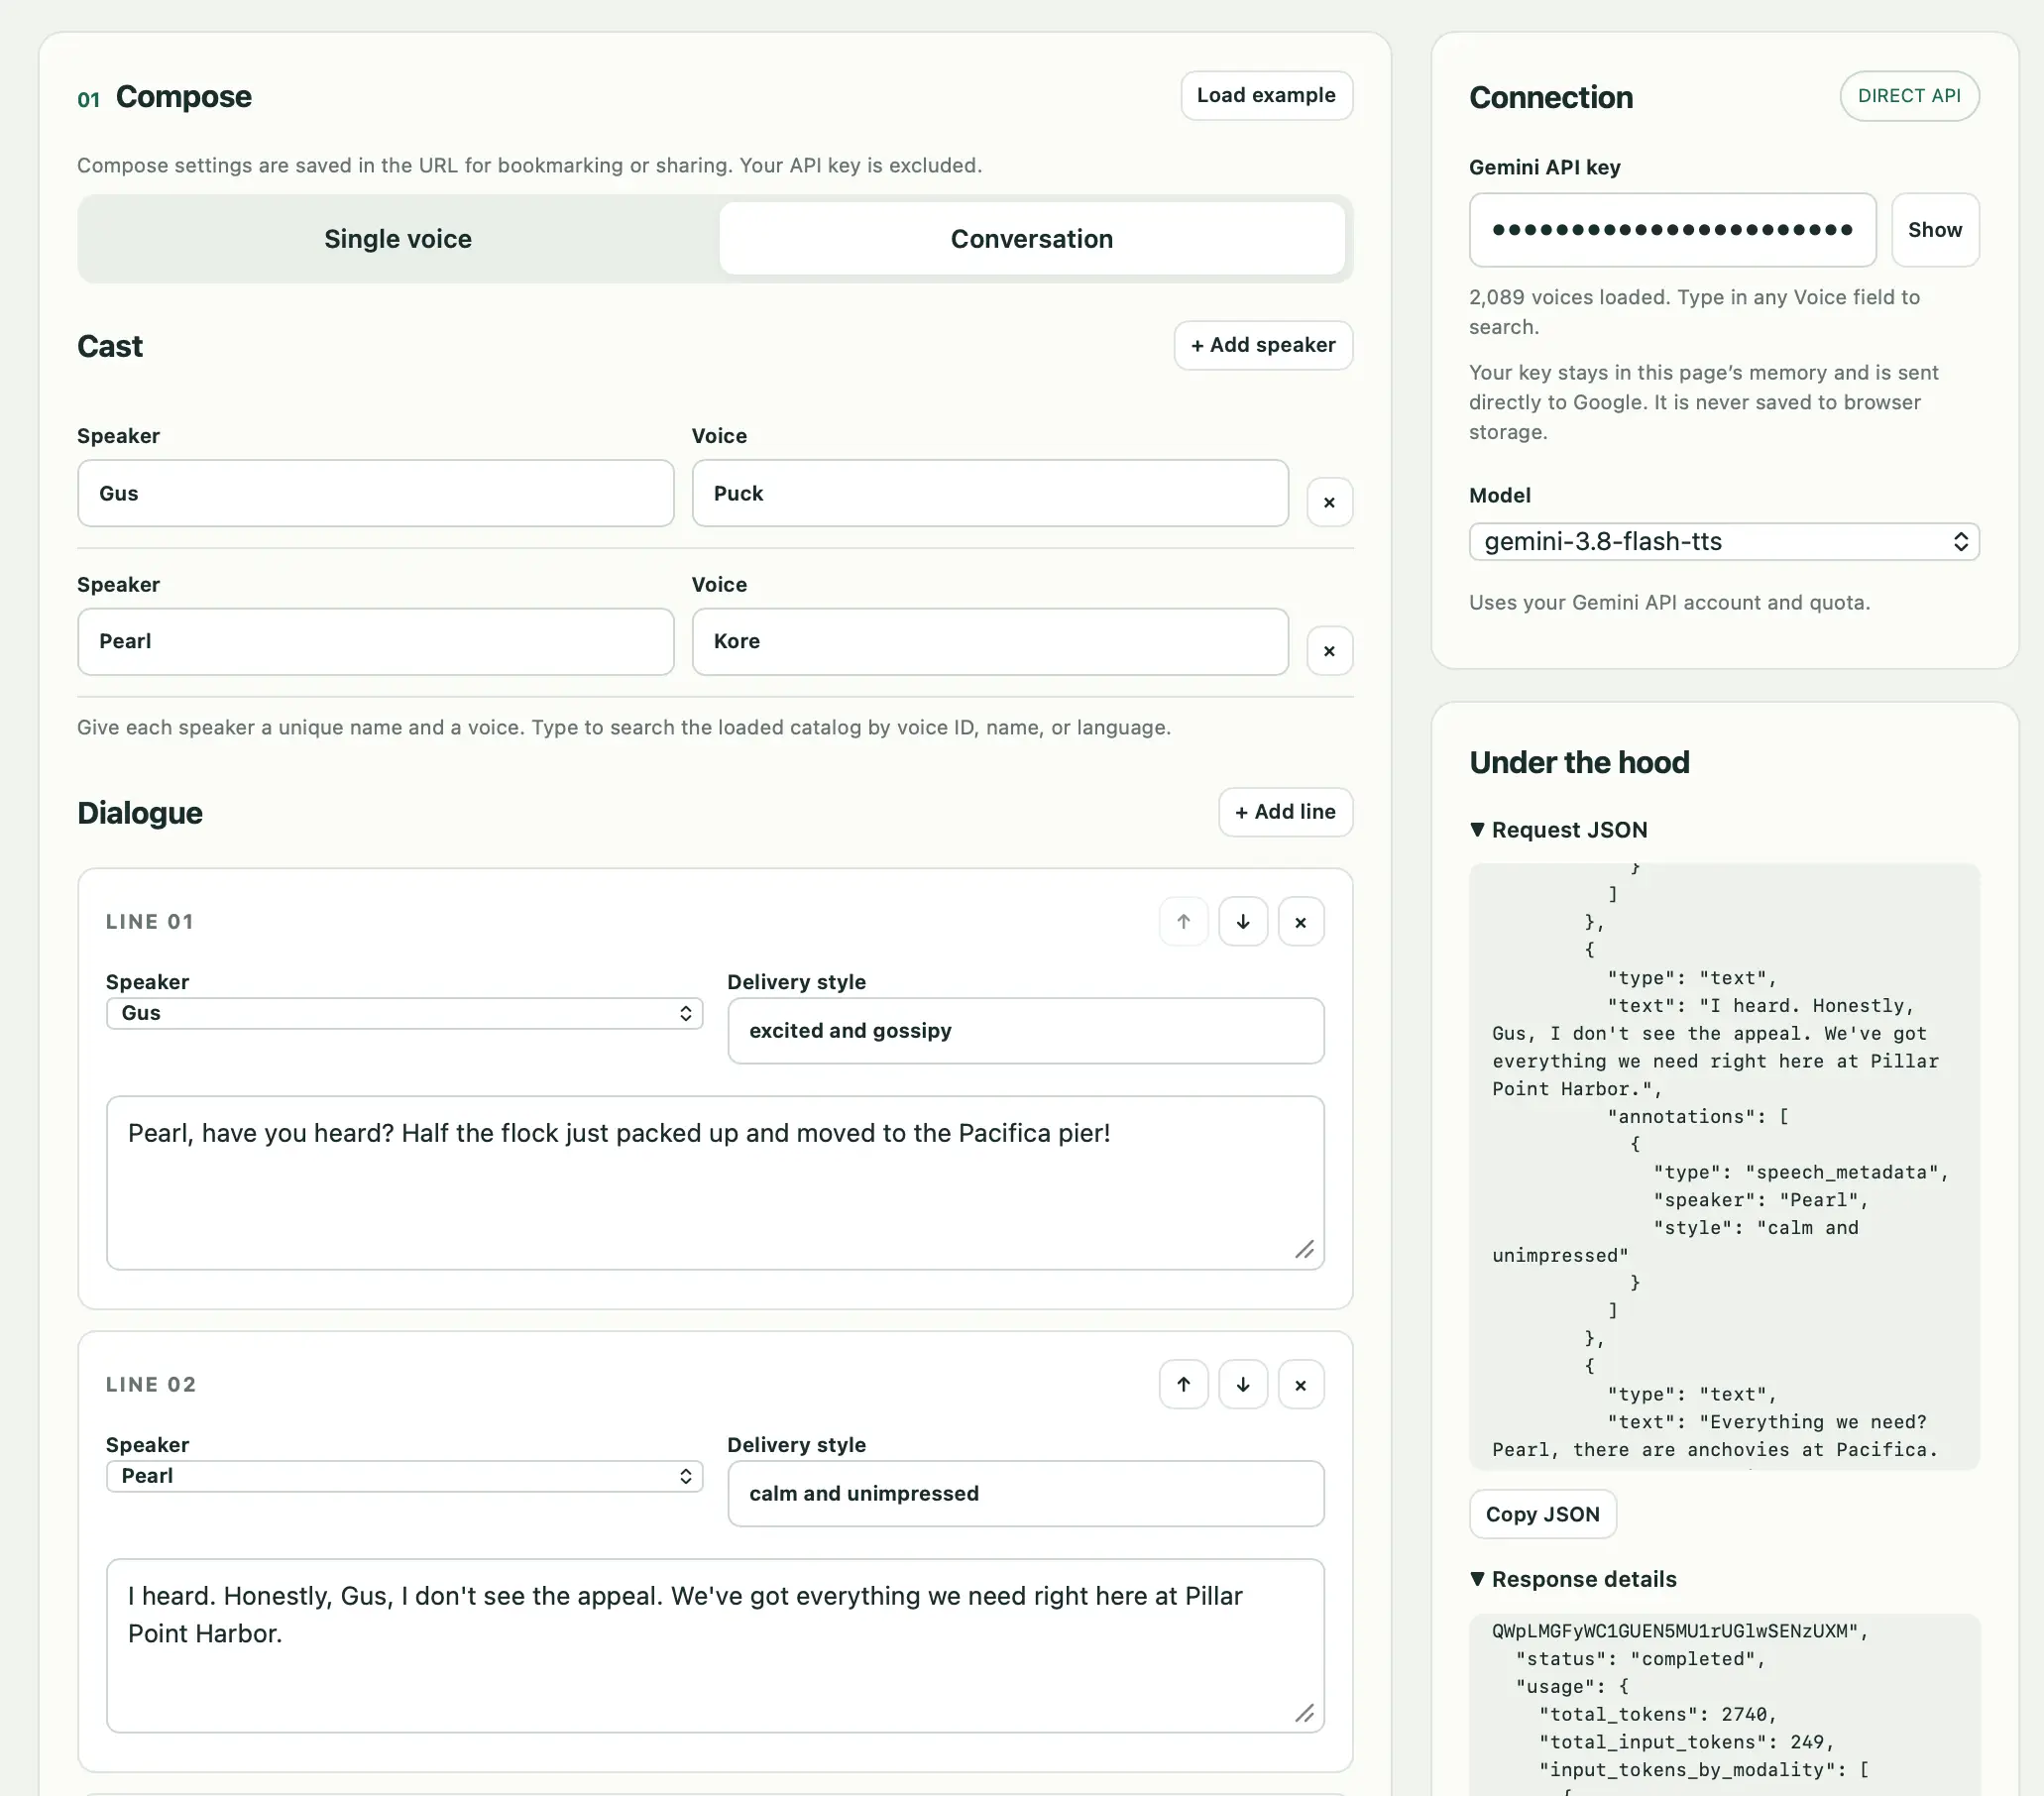
- 该API原生支持定义完整多角色对话,每个角色可独立配置音色与语音风格指令,简化剧本到成品的开发流程。
- 开发者Simon Willison利用Gemini API开放的CORS策略,结合GPT-6 Astra构建了“自带密钥”的Playground界面,Claude 4.5 Opus负责生成对话脚本并渲染为音频URL。
背景与事实
2026年9月23日,谷歌正式发布两款面向文本转语音场景的Gemini 3.8系列模型:gemini-3.8-flash-tts与gemini-3.8-flash-lite-tts。两款模型均内置超过2000种预设音色库,覆盖不同语言、语速、情感风格与角色特征,用户可直接调用而无需额外训练。更关键的是,两者都支持通过“仅30秒音频样本”创建自定义语音,样本可以是用户本人的声音,也可以是用户拥有合法使用权的其他声音,这一机制显著降低了语音克隆的技术门槛与数据准备成本。
据开发者Simon Willison演示,他利用GPT-6 Astra“vibe coding”(即兴编码)方式,构建了一个支持用户自带API密钥的Playground交互界面,直接调用了底层Gemini TTS API。该API的一个突出特性是允许开发者在单次请求中定义完整的多角色对话,每个角色可独立指定音色编号与语音风格指令(如语速、音调、情绪强度等),无需分段合成再拼接,大幅简化了有声书、播客、游戏配音等场景的开发流程。
在性能与成本方面,Willison使用gemini-3.8-flash-tts(非更低价的Flash-Lite版本)生成了一段1分18秒的双鹈鹕辩论对话(剧本由Claude 4.5 Opus编写并生成渲染URL),整个生成过程耗时约20秒,总成本仅为0.0274美元(2.74美分)。这一数据表明,在高精度TTS模型上,单位时长音频的合成成本已降至极低成本区间,使得高频次、多角色的语音生成在经济上具备大规模商用可行性。
影响分析
对于中文开发者与从业者而言,这一发布意味着多角色语音合成项目从“拼接式工作流”转向“单次调用式工作流”。过去,若需让两个角色同时发声,开发者必须分别调用TTS接口生成两段音频,再在客户端进行时间轴对齐与混音;如今,通过单一定义多角色对话的API参数,可在服务端一次性完成,减少了网络往返、时序误差与客户端复杂度。30秒音频即可克隆自定义语音的特性,也降低了真人配音授权的合规门槛——使用者只需证明对样本声音拥有合法使用权,无需与配音演员签订长期数据授权协议。从成本角度看,2.74美分生成1分18秒音频的单价,使得教育类多角色互动内容、游戏内动态对话、无障碍阅读等多角色语音场景的边际成本趋近于零,预计将催生大量此前因成本或开发复杂度而未能落地的应用形态。
适用边界
上述结论与数据基于gemini-3.8-flash-tts模型的公开演示,不直接适用于gemini-3.8-flash-lite-tts的低成本版本(其延迟与音色保真度可能不同),也不适用于非谷歌生态的TTS服务商。30秒音频克隆自定义语音的前提是使用者对样本声音拥有合法权利,若使用未授权的他人声音进行克隆,仍存在法律与合规风险。此外,Playground界面依赖Gemini API开放的CORS策略与GPT-6 Astra的编码能力,若谷歌未来收紧API跨域策略或工具链变更,该快速原型流程可能不再直接适用。
孤本观察
本次发布中“多角色对话单次API调用”与“30秒音频克隆”两项特性组合,实际上将语音合成从“工具链”重新定义为“剧本执行引擎”——开发者只需提供角色设定与对话文本,音频生成的时序、音色切换与风格控制均下沉至模型层。这一判断表明,未来语音类应用的竞争焦点可能从合成质量转向剧本编排能力与角色一致性维持,而非单纯的音色丰富度。
常见问题
创建自定义语音模型需要多长的音频样本?
仅需提供30秒的音频样本,可以是用户本人声音或已获授权的声音。
生成1分18秒多角色对话音频的成本是多少?
使用gemini-3.8-flash-tts模型,成本仅为0.0274美元(约2.74美分)。
两款新模型各自提供多少种预设音色?
gemini-3.8-flash-tts与gemini-3.8-flash-lite-tts均提供超过2000种预设音色。
如何在不分段拼接的情况下生成多角色对话?
通过API原生支持的单次请求功能,可为每个角色独立配置音色与语音风格指令。
克隆自定义语音有什么合规前提条件?
使用者必须对样本声音拥有合法使用权,若使用未授权他人声音则存在法律与合规风险。