

一句话结论
谷歌于 2026 年 9 月 15 日发布 Gemini 3.8 Live 及扩展思考版模型,用户可直接通过浏览器 WebSocket 连接实现带打断功能的语音对话。
关键要点
- 谷歌在 2026 年 9 月 15 日正式推出 Gemini 3.8 Live 与 Gemini 3.8 Live Extended Thinking 两款语音到语音模型。
- 该模型架构与 OpenAI 的 GPT-Live 系列相似,均支持实时语音交互场景。
- 开发者使用浏览器 Web Audio API 和原生 WebSocket 即可构建无第三方库依赖的对话界面,无需引入额外 JS 框架。
- 支持的系统功能包括选择模型与声音预设、输入可选的系统提示词,以及在模型讲话过程中随时打断。
- 接口端点采用 BidiGenerateContent 双向流协议,通过 wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent 进行通信。
背景与事实
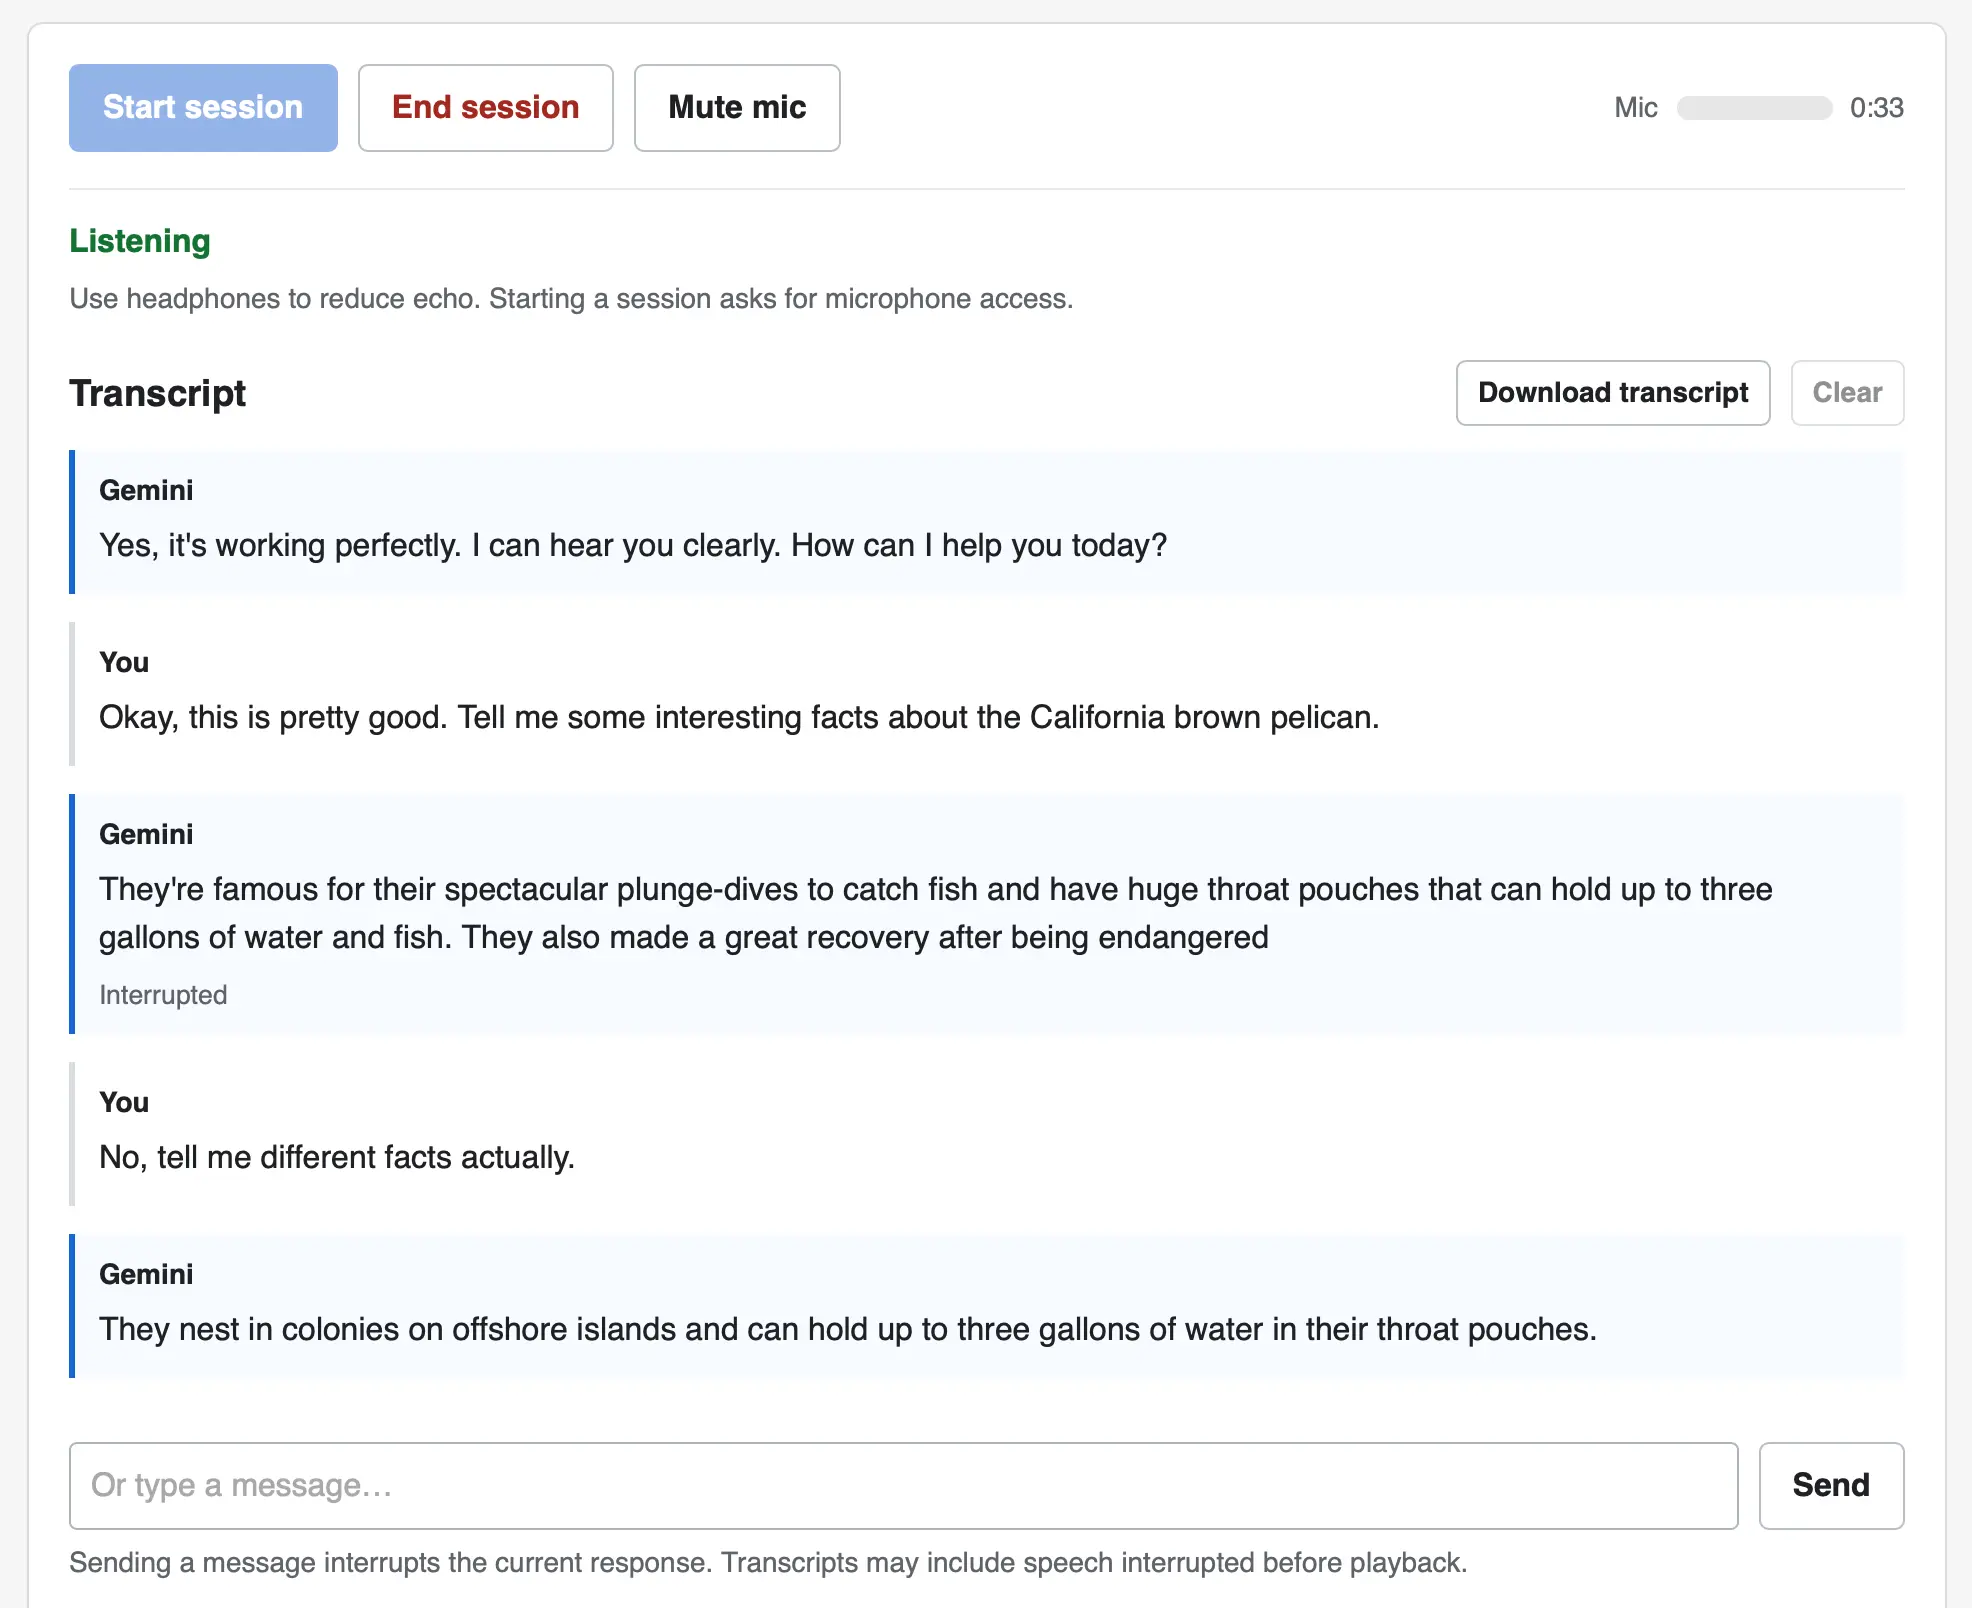
2026 年 9 月 15 日,谷歌官方发布了 Gemini 3.8 Live 和 Gemini 3.8 Live Extended Thinking 两款新模型。此次发布的模型定位于语音到语音交互,其整体形态与 OpenAI 此前推出的 GPT-Live 系列具有可比性,主要面向需要低延迟、自然打断能力的语音应用场景。发布同日,科技博主 Simon Willison 展示了基于该模型文档构建的网页端用户界面示例。该界面允许用户直接在浏览器中发起语音对话,并支持在模型响应过程中进行人工打断,从而模拟真实的人类对话节奏。
技术实现方面,该示例 UI 未使用任何第三方 JavaScript 库或框架。前端通过原生 WebSocket 连接至谷歌生成式 AI 接口端点,具体地址为 wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent?key=...。音频采集与播放环节均采用浏览器原生的 Web Audio API,利用 AudioContext 对象处理实时音频流。用户可在界面中选择特定的模型版本和声音预设,并可选择性输入系统提示词以调整模型行为边界。谷歌同步提供了 Gemini Live 教程文档,指导开发者如何快速接入该 WebSocket API。
从时间线来看,该发布处于 2026 年 9 月中旬,同期市场上其他厂商也在进行模型迭代。Simon Willison 的近期文章还提及了 Claude Opus 5.5、GPT-6 Sol、GPT-6 Luna 等竞品动态,以及 Jev 公司推出的 System One 决策模型,表明当前大模型行业正处于多形态、多赛道并进的密集竞争期。
影响分析
对中文开发者而言,此次发布意味着浏览器端即可实现高质量的语音交互功能,而无需部署复杂的后端音频服务或依赖重型前端框架。由于实现示例不依赖第三方库,大幅降低了技术门槛和项目体积,特别适合需要快速原型验证或资源受限环境的团队。语音打断功能的原生支持,使得智能助手、语音客服等场景的交互体验更接近真人对话,减少了用户等待和打断失败的挫败感。开发者可参考其 WebSocket 直连模式,避免中间代理层带来的额外延迟,从而优化端到端响应速度。
适用边界
上述无依赖浏览器实现方案主要适用于现代主流浏览器环境,对老旧浏览器或移动端弱网场景可能因 WebSocket 长连接稳定性或 Web Audio API 兼容性而受限。此外,直接连接谷歌 API 端点涉及 API Key 管理,在生产环境中需遵循安全规范,不可在前端硬编码密钥,此部分细节未在来源示例中展开。模型性能与扩展思考版的延迟权衡,亦需结合具体业务场景测试确定,并非所有实时场景都适用 Extended Thinking 模式。
孤本观察
编辑判断:谷歌此次选择以 WebSocket 双向流作为浏览器端主要接入方式,并强调无依赖实现,显示出其在降低语音交互前端技术壁垒方面的明确策略,旨在吸引独立开发者与非传统 AI 团队快速集成语音能力。
常见问题
Gemini 3.8 Live 系列模型的发布时间是哪天?
谷歌于 2026 年 9 月 15 日正式发布该系列模型。
开发者如何实现无第三方库依赖的语音交互界面?
通过浏览器原生 WebSocket 连接至谷歌接口,并使用 Web Audio API 处理音频,无需引入额外 JS 框架。
该模型接口使用的通信协议及端点地址是什么?
采用 BidiGenerateContent 双向流协议,端点为 wss://generativelanguage.googleapis.com/ws/google.ai.generativelanguage.v1alpha.GenerativeService.BidiGenerateContent。
无依赖浏览器实现方案有哪些适用限制?
主要适用于现代主流浏览器,老旧浏览器或移动端弱网场景可能受限于 WebSocket 稳定性及 Web Audio API 兼容性。
生产环境中直接连接谷歌 API 端点需注意什么?
需遵循安全规范管理 API Key,不可在前端硬编码密钥。