

一句话结论
NVIDIA 发布 64GB 统一内存版 DGX Spark,单机支持 100 亿参数模型,双机集群可达 128GB 并支持 200 亿参数模型。
关键要点
- 64GB 版本于 10 月 23 日通过宏碁、华硕、戴尔、技嘉、惠普和微星六家合作伙伴发售,起售价 4999 美元。
- 64GB 单机版支持完全在设备端运行最高 1000 亿参数模型;双机集群总内存达 128GB,模型上限升至 2000 亿参数。
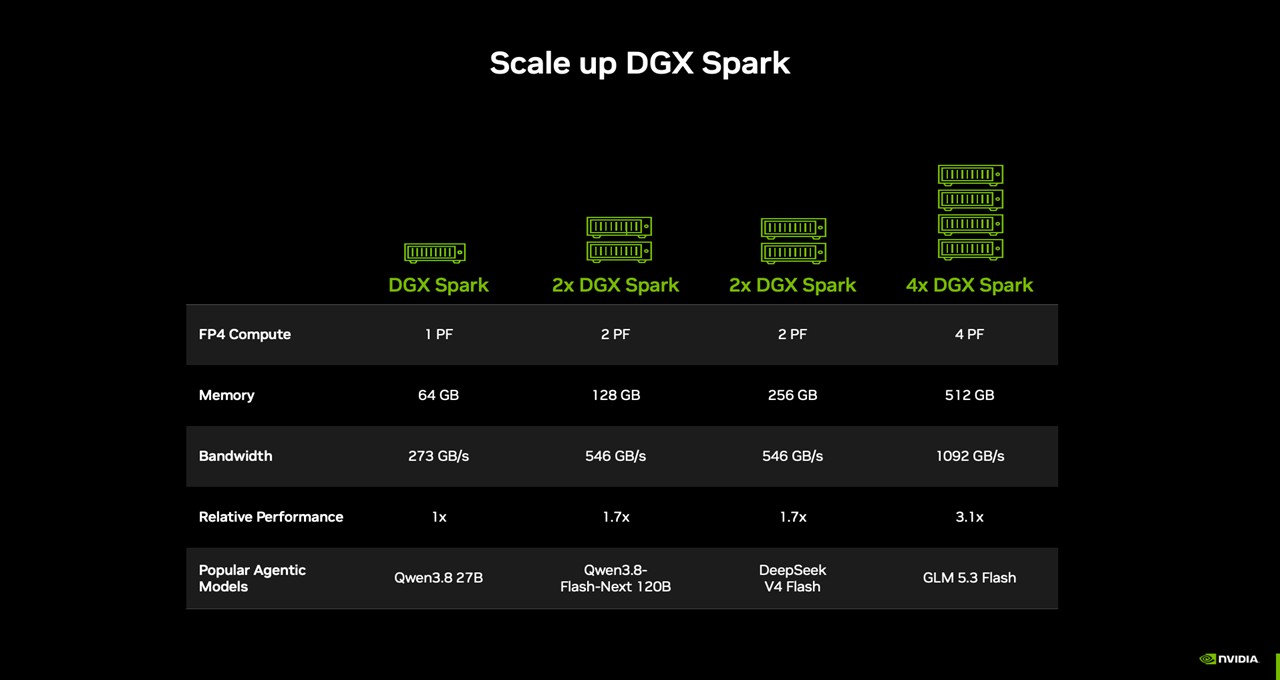
- 官方实测 Qwen 3.8 27B 模型时,双机集群性能达单机的 1.7 倍,且无需额外配置即可通过 NVIDIA Sync Cluster Assistant 完成组网。
- 系统预装 NVIDIA Agent Toolkit、CUDA-X AI 库、Nemotron 开放模型,兼容 Ollama、vLLM、PyTorch 等主流运行时,开机数分钟内即可运行模型。
- Blender 成为首批支持该平台的创作者应用,预构建安装包即将上线;月底将推出 NVIDIA Sync Model Launcher,支持一键部署 Qwen 3.8 27B 到单机或集群。
背景与事实
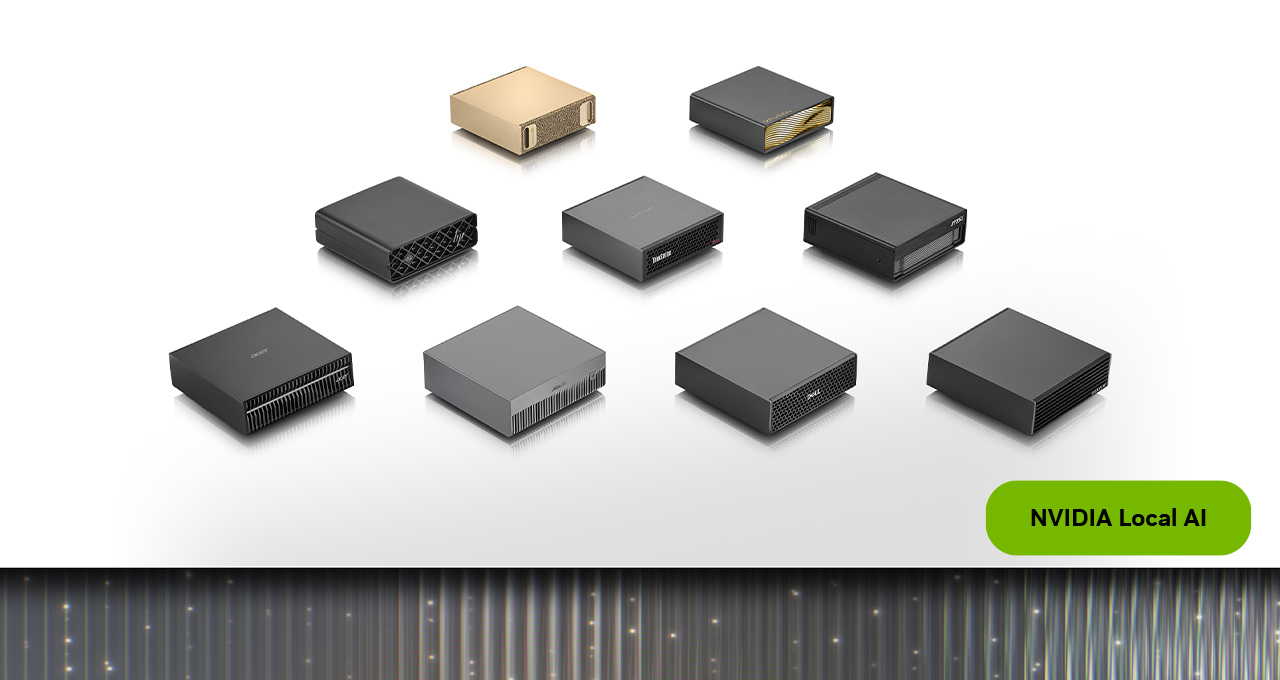
NVIDIA 本月宣布 DGX Spark 新增 64GB 统一内存配置,通过 Acer、ASUS、Dell、Gigabyte、HP、MSI 六大制造商渠道同步上市,10 月 23 日开放购买,起售价 4999 美元。该版本保留 GB10 Grace Blackwell 超级芯片、DGX OS 及完整 NVIDIA AI 软件栈,规格与 128GB 型号一致,仅在内存容量上缩减至 64GB,从而将入门价格控制在可触及区间。平台将 NVIDIA Grace Blackwell 计算单元、统一内存、NVIDIA ConnectX-7 网络接口与 CUDA 加速 AI 软件栈整合为一体,定位面向智能体开发、推理、微调、数据科学及边缘场景的本地 AI 超算。
单机 64GB 配置即可完整运行最高 1000 亿参数模型及其智能体应用,全程无需依赖云端算力。当工作负载超出单机内存上限时,用户可通过 QSFP 线缆直连两台 64GB 设备,利用预装的 NVIDIA ConnectX-7 网卡将内存池化至 128GB,模型支持上限同步扩展至 2000 亿参数,内存带宽翻倍,性能提升最高达 1.7 倍。NVIDIA Sync 应用中的 Cluster Assistant 功能可自动检测相连设备、验证配置并配置 ConnectX-7 网络,所有节点运行相同软件栈,从单机扩展至双机无需重新配置任何参数。
软件生态方面,DGX Spark 出厂即预装 NVIDIA Agent Toolkit、CUDA-X AI 库、Nemotron 开放模型,并开箱支持 Ollama、vLLM、PyTorch(CUDA 版)等运行时,开发者从开机到运行模型仅需数分钟。Blender 是首批宣布支持该平台的创作者应用,预构建可下载安装包即将上线。月底将发布 NVIDIA Sync Model Launcher,允许用户通过几按钮操作下载并在单机或集群上运行 Qwen 3.8 27B,NVIDIA Sync 自动配置模型跨设备运行并使其可从笔记本电脑访问,同时自动设置 OpenCode 调用该模型,开发者可在浏览器中直接开始编码。
影响分析
对中文开发者而言,这一配置在价格与性能之间提供了明确取舍:4999 美元起售价相比 128GB 版本显著降低入门门槛,使 1000 亿参数级模型的本地推理、微调与智能体开发不再强制依赖云端 GPU 集群,适合数据敏感或网络受限场景。双机 128GB 方案以约 1 万美元成本实现 2000 亿参数模型支持,性能提升 1.7 倍且配置零摩擦,为中小团队和研究人员提供了无需专业机房即可扩展算力的路径。预装的 Agent Toolkit 与 Ollama、vLLM 兼容性降低了本地智能体应用的技术门槛,月底 Model Launcher 进一步将模型部署简化为图形化操作,直接惠及缺乏系统运维经验的开发者群体。判断来看,这一产品线正在将"本地 AI 超算"从概念推向消费级可采购硬件。
适用边界
上述结论基于 1000 亿至 2000 亿参数级模型在本地硬件上运行这一前提。若开发者需要训练或微调参数规模超过 2000 亿的大型模型,或工作负载依赖多模态实时处理、超高吞吐推理等超出双机 128GB 内存与带宽上限的场景,该方案不适用。此外,64GB 单机配置无法运行超过 1000 亿参数模型,需要集群扩展;若用户仅需轻量推理或边缘实时任务,128GB 版本或消费级 GPU 方案在性价比上可能更优,本方案的价值集中在中大规模本地模型开发与智能体应用这一特定区间。
孤本观察
从 64GB 到 128GB 双机的"内存池化+性能 1.7 倍"设计,表明 NVIDIA 正在将本地 AI 的扩展逻辑从"买更大单机"转向"低成本多机组合",这一定位判断意味着后续硬件迭代可能优先优化互联协议而非单机算力。
常见问题
NVIDIA DGX Spark 64GB 版本的起售价是多少,何时发售?
起售价为 4999 美元,于 10 月 23 日通过宏碁、华硕等六家合作伙伴发售。
DGX Spark 64GB 单机版和双机集群版分别支持多大参数的模型?
单机版支持最高 1000 亿参数模型;双机集群总内存达 128GB,模型上限升至 2000 亿参数。
在实测 Qwen 3.8 27B 模型时,双机集群相比单机的性能提升是多少?
官方实测显示,双机集群性能达单机的 1.7 倍,且无需额外配置即可通过 NVIDIA Sync Cluster Assistant 完成组网。
DGX Spark 平台预装了哪些软件生态?
预装 NVIDIA Agent Toolkit、CUDA-X AI 库、Nemotron 开放模型,并兼容 Ollama、vLLM、PyTorch 等主流运行时。
DGX Spark 64GB 版本在哪些硬件规格上与 128GB 型号保持一致?
保留 GB10 Grace Blackwell 超级芯片、DGX OS 及完整 NVIDIA AI 软件栈,规格与 128GB 型号一致,仅在内存容量上缩减至 64GB。
来源:NVIDIA Blog