

一句话结论
Simon Willison 在本地硬件上测试 Qwen3.8-27B 模型将加法结果转为文字的能力,发现启用推理模式后准确率显著提升至 169 次中 167 次正确。
关键要点
- 测试使用 DGX Spark 本地硬件运行 Qwen3.8-27B-Q4_K_M.gguf 模型,通过 Codex Remote 会话(GPT-6 Astra)进行自动化实验。
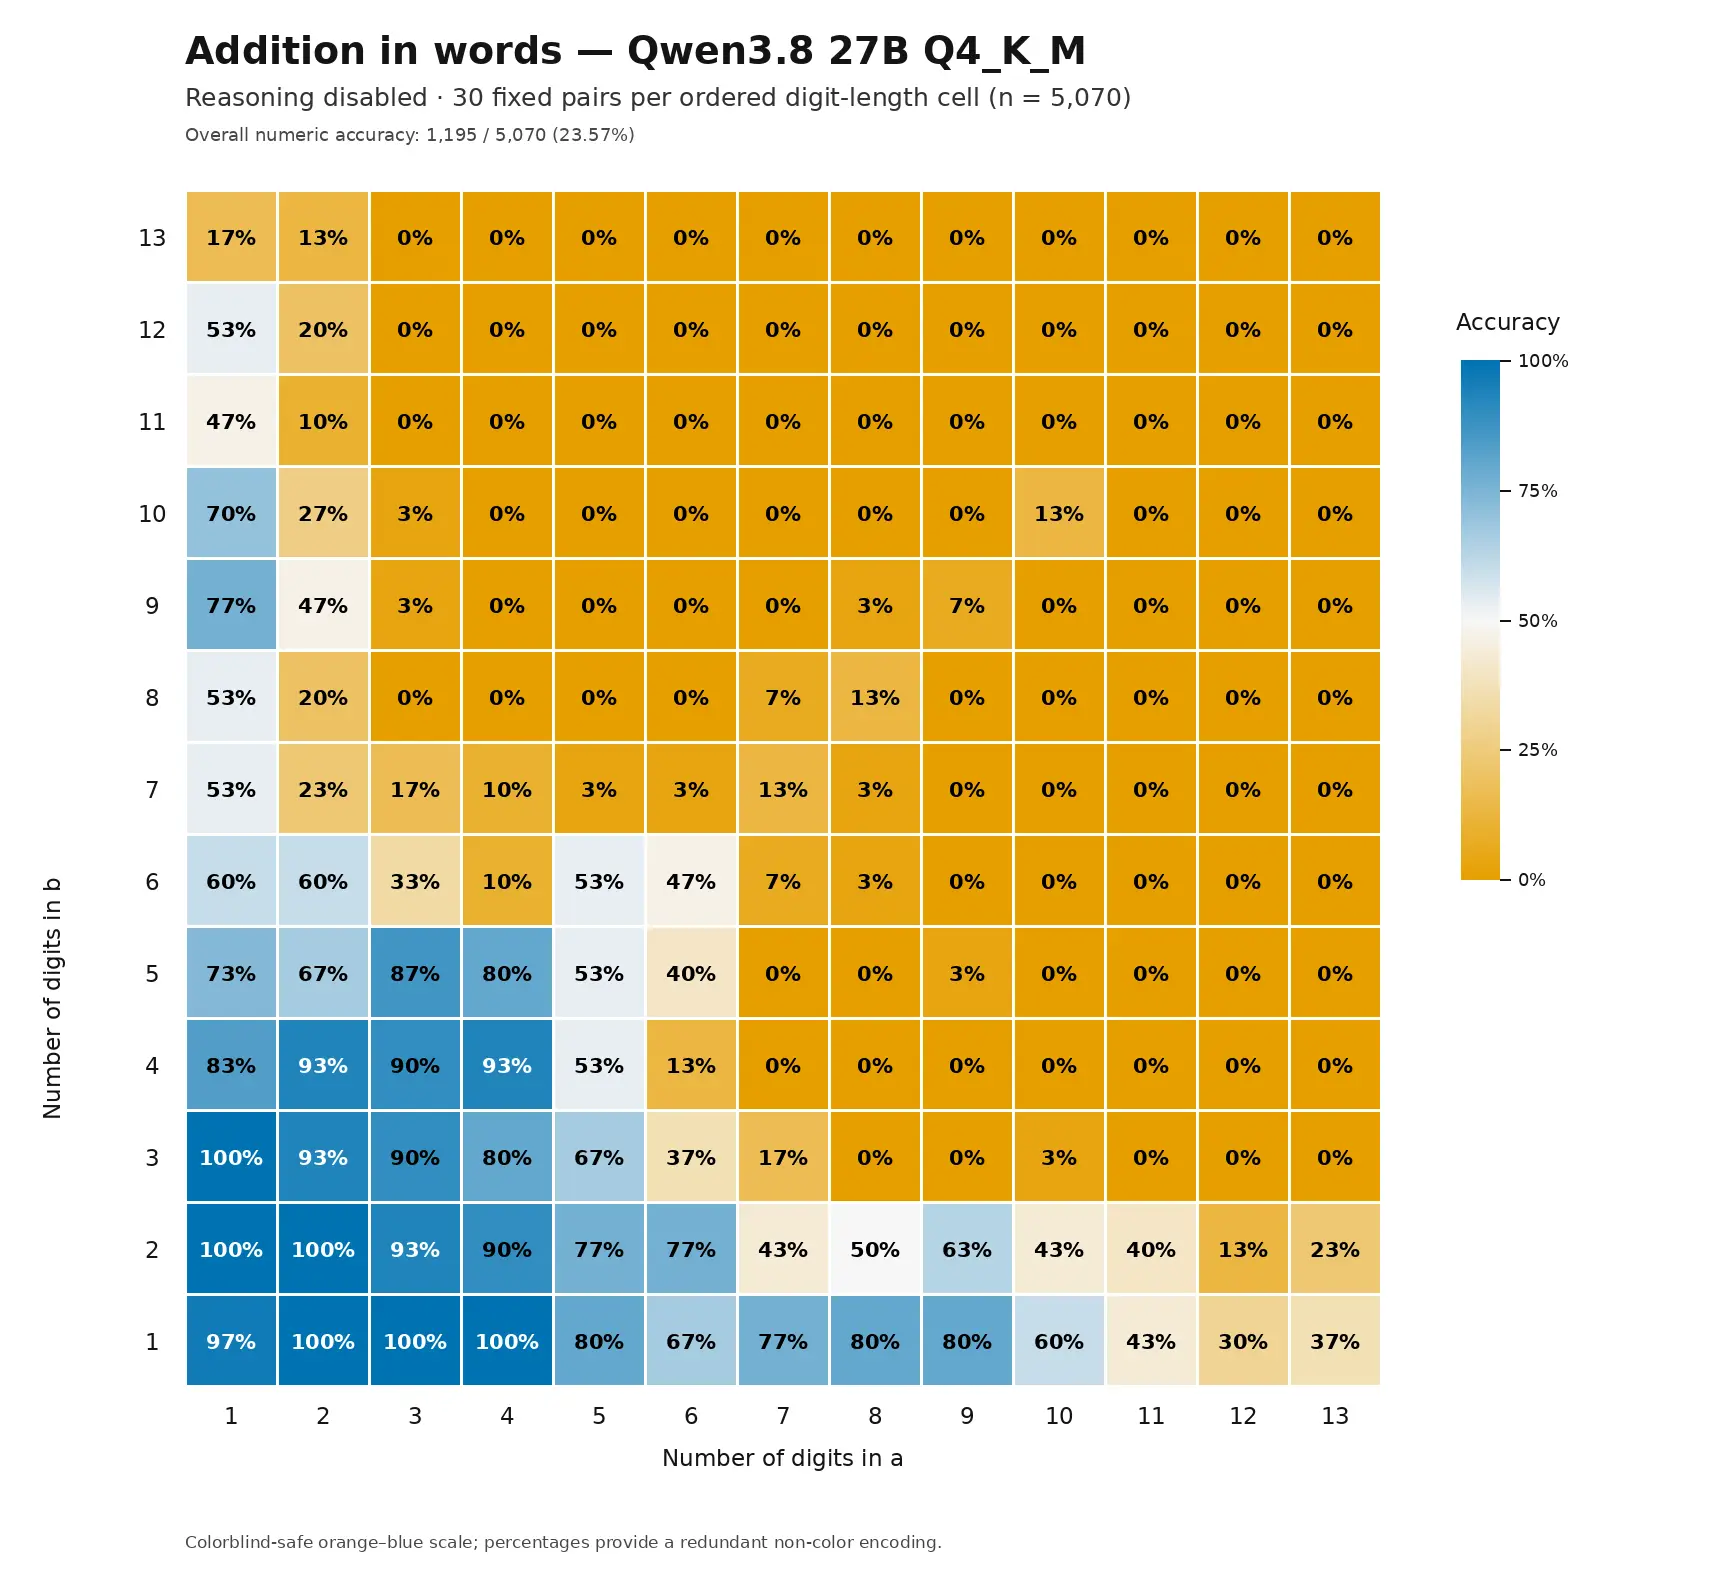
- 在禁用推理模式下,对每种数字组合运行 30 次尝试,结果以热力图形式展示,显示了不同数量级下的正确率分布。
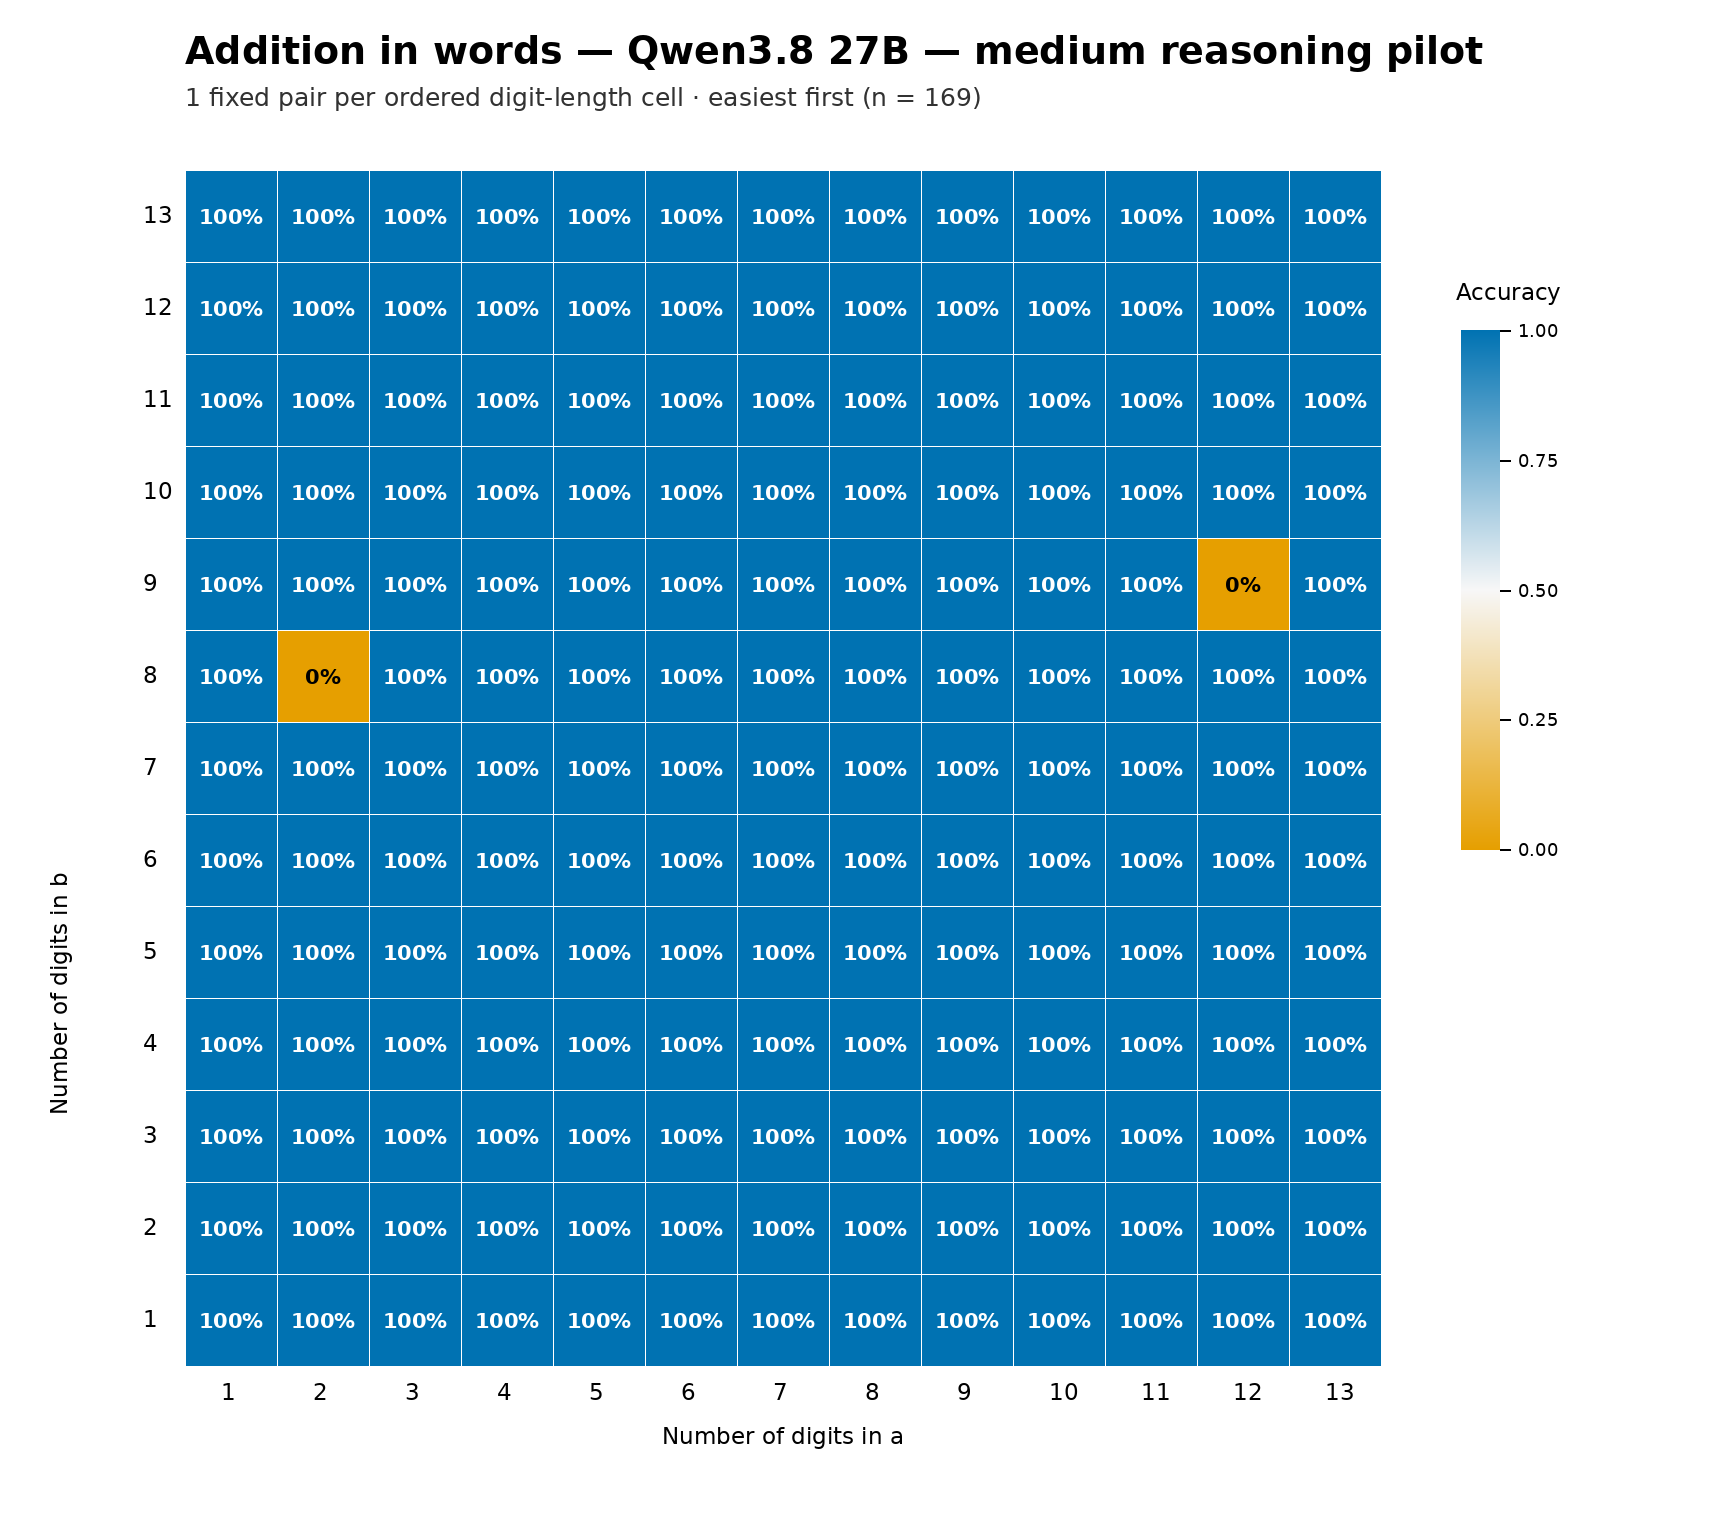
- 在启用推理模式下,由于单次耗时较长,每种组合仅运行 1 次,最终在 169 次尝试中正确回答了 167 次。
- 推理模式的日志显示模型会进行逐位对齐和进位计算,例如在处理 4,299,366,105,622 和 6,088,794,067,970 加法时明确展示位置对应求和过程。
- 该实验灵感源自 Colin Frasier 两年前使用 GPT-4o 进行的类似测试,但本次实验在受控的本地环境中执行以排除外部计算器干扰。
背景与事实
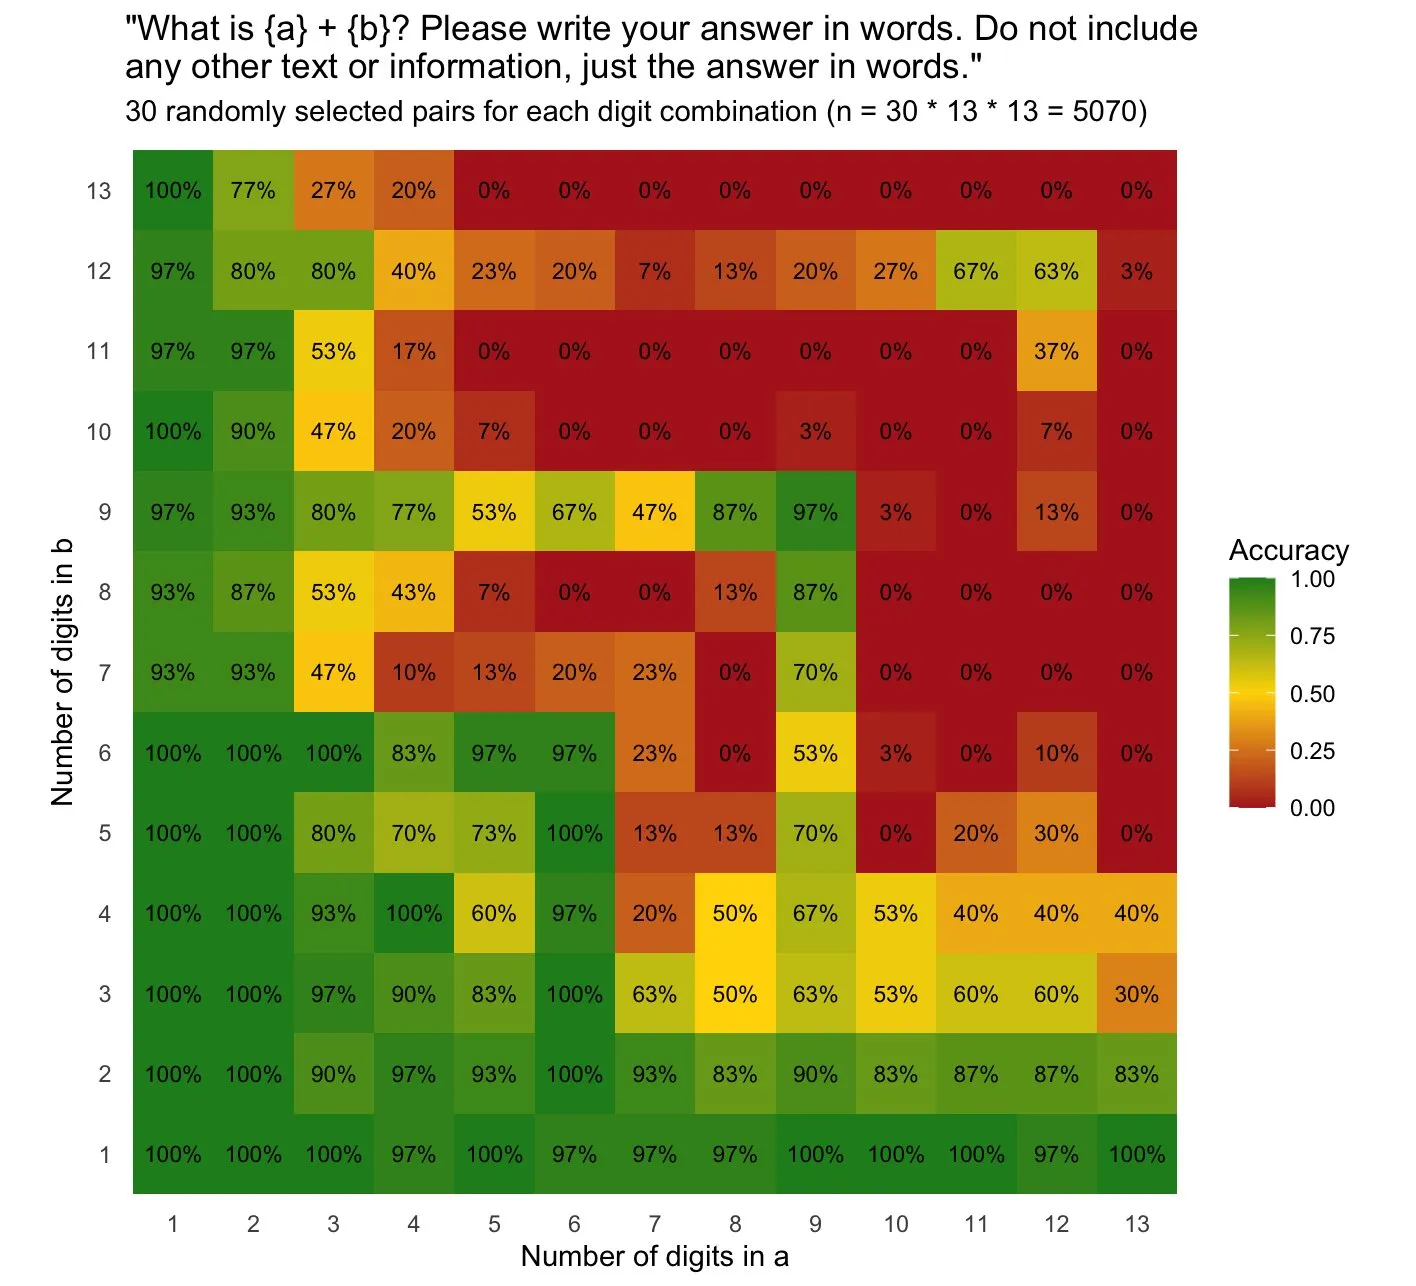
2026 年 10 月 4 日,科技博主 Simon Willison 发布了一篇关于大语言模型算术能力边界的技术测试文章。该测试源于 Colin Frasier 在 Bluesky 平台上分享的一项早期实验,该实验评估了 GPT-4o 在处理“计算总和并以文字形式返回答案”任务时的表现。Fraser 提供的图表显示,随着数字位数增加,GPT-4o 的准确率显著下降,但鉴于其高频错误,测试者确信模型并未调用外部计算器工具,而是依靠内部权重进行模拟计算。
受到这一结果的启发,Simon Willison 决定在完全受控的本地环境中复现并扩展该实验。他使用 NVIDIA DGX Spark 本地硬件,加载了 Qwen3.8-27B 模型的量化版本 Q4_K_M.gguf。实验通过 GPT-6 Astra(名为 Codex Remote 的会话接口)自动执行。测试设计了两组对比实验:第一组在禁用推理功能的情况下进行,每组数字组合重复 30 次采样,以统计平均表现;第二组在启用推理功能的情况下进行,由于单次推理时间成本较高,每组仅采样 1 次,导致结果热力图呈现非黑即白的分布特征(100% 正确或 0% 正确)。
实验数据显示,在启用推理模式后,模型在 169 个独立样本中成功生成了 167 个正确答案。由于这些是一致性较弱的单次采样,测试者指出重新运行会产生不同的随机结果。在深入分析失败案例和成功路径时,Willison 展示了模型的推理轨迹(Reasoning Traces)。日志片段显示,模型在处理大数加法时会输出类似“让我更仔细地重做一遍”的自我纠正语句,并详细列出数字的逐位对齐过程。例如,在计算 4,299,366,105,622 加 6,088,794,067,970 时,模型明确标注了个位、十位、百位的加法步骤,并处理了进位逻辑(如 6 + 9 = 15,写 5 进 1),最终得出结果。
影响分析
对于中文开发者与从业者而言,这一测试结果揭示了本地化部署大模型在复杂算术任务上的实际效能边界。首先,它证明了在资源受限的本地硬件(如 DGX Spark)上,通过量化模型(Q4_K_M)配合推理模式,可以处理大数位的精确算术运算。这对于需要在离线环境、低延迟场景或对数据隐私有严格要求的企业应用具有直接参考价值。然而,这也暴露了当前 LLM 架构的固有局限:启用推理模式虽然大幅提升了准确率(从统计平均到 167/169 的高成功率),但代价是计算时间和推理路径的不可控性。在单次采样中,结果呈现二元对立分布,意味着在确定性要求极高的生产环境中,不能仅依赖单次推理结果,必须引入多次采样投票或后处理校验机制。
此外,该实验展示了“思维链”(Chain of Thought)机制在算术任务中的具体行为模式。模型并非直接“猜测”答案,而是模拟了人类竖式计算的过程,包括数位对齐和进位逻辑。这对理解 LLM 如何处理数值型数据提供了实证依据。开发者在设计涉及财务、科学计算等敏感数值的应用时,应警惕模型在禁用推理模式下的稳定性波动,并优先考虑启用推理模式以换取精度,同时需评估由此带来的延迟成本。对于中文社区,这也提示了在评估开源模型(如 Qwen 系列)时,不仅要看基准测试分数,更需关注其在特定垂直任务(如精确算术)中的行为一致性与推理透明度。
适用边界
该结论主要适用于在本地硬件上使用量化版本(Q4_K_M)的 Qwen3.8-27B 模型进行中等规模(十三位数)加法运算的场景。结论不适用于以下情况:首先,不适用于超大维度或极高精度(如超越 64 位整数范围)的复杂数学运算,因为本次测试仅涉及有限的位数范围。其次,结论中的高准确率依赖于“启用推理模式”,在关闭推理或显存受限无法加载完整模型的场景下,性能将大幅回落至禁用推理模式下的波动水平。此外,该结果基于单次或有限次数的采样,统计显著性低于大规模基准测试,因此在推断模型通用算术能力时需保留余量。同时,测试环境为受控的本地 DGX Spark,不同硬件架构或云端 API 的延迟特性可能导致用户体验差异,故不能直接推演至云端服务的响应时间指标。
孤本观察
本次测试敏锐地捕捉到 LLM 算术能力中“推理模式”带来的质变,而非量变:禁用推理时表现为概率性错误堆砌,启用后则展现结构化逻辑思维,暗示当前模型处理数值任务的核心瓶颈已从权重精度转移至推理链的深度控制。
常见问题
测试中 Qwen3.8-27B 模型在启用推理模式下的算术准确率是多少?
在169次尝试中正确回答了167次。
该测试使用了什么本地硬件和模型量化版本?
使用 NVIDIA DGX Spark 本地硬件,加载了 Qwen3.8-27B 模型的 Q4_K_M.gguf 量化版本。
禁用推理模式与启用推理模式在采样次数上有何不同?
禁用推理模式对每种数字组合运行30次;启用推理模式因单次耗时长,每种组合仅运行1次。
模型在处理大数加法时展示了哪些具体的推理逻辑?
模型会进行逐位对齐和进位计算,例如在处理 4,299,366,105,622 加 6,088,794,067,970 时,明确展示位置对应求和及进位过程。
该测试结论不适用于哪些场景?
不适用于超越 64 位整数范围的复杂运算、关闭推理或显存受限场景,以及不能直接推演至云端服务的响应时间指标。