

一句话结论
NVIDIA 确立电力为 AI 工厂核心约束,通过全栈协同设计将单兆瓦成本控制在约 6000 万美元,并推动资产跨代互通以最大化投资回报。
关键要点
- 单个兆瓦规模的 NVIDIA AI 工厂建造成本约为 6000 万美元,电力容量成为决定盈利能力的首要约束条件。
- 新一代 Vera Rubin NVL72 系统每兆瓦吞吐量较 GB300 NVL72 提升超 30 倍,特定模型下每百万 Token 成本最高可降低 45 倍。
- 旧代硬件仍具显著商业价值,如 A100 GPU 租赁合同期延长至 2029 年,6 年历史资产残值约为原成本的 25%。
- 超过 1000 个 CUDA-X 库及百万级开发者生态,确保单一架构能支持机器学习、科学计算及图形处理等多样化工作负载。
- 通用加速计算设备集成张量核心与 Transformer 引擎,达索系统等企业借此将部分产品生产成本降低 50%。
背景与事实
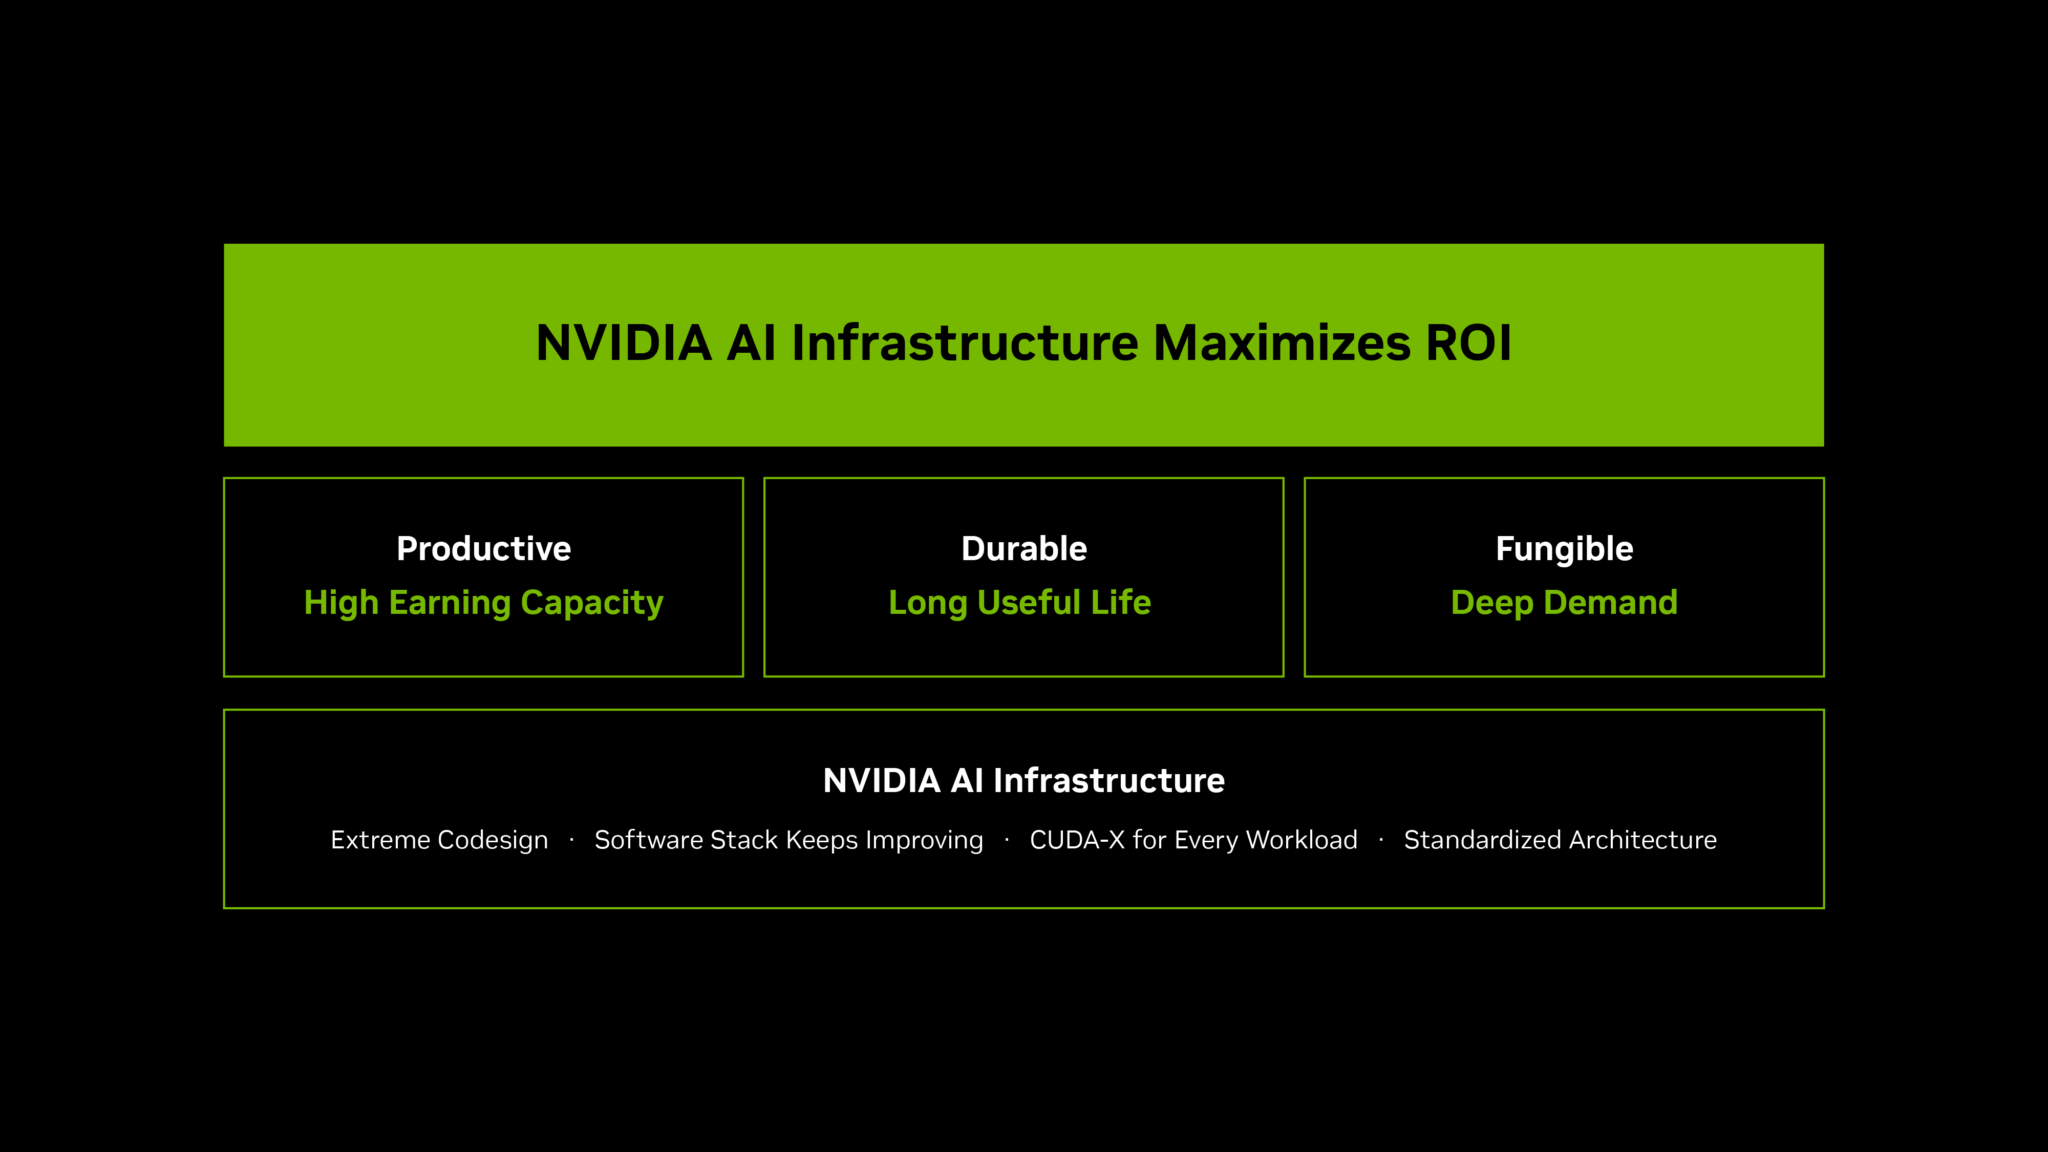
NVIDIA 正在重新定义 AI 基础设施的经济模型,其核心逻辑是将 AI 工厂视为以“兆瓦”为基本建造单位的资产。在这种架构下,电力不仅是物理限制,更是财务指标的决定因素。NVIDIA 提出,衡量 AI 工厂盈利能力的黄金标准是“每兆瓦每秒 Token 数”。由于 Token 生成是主要产出,每百万 Token 成本的降低直接转化为利润空间的扩大。据半导体研究机构 SemiAnalysis 的 AgentX 数据模型显示,NVIDIA 最新的 Vera Rubin NVL72 系统与上一代 GB300 NVL72 相比,在每兆瓦吞吐量上实现了超过 30 倍的跃升。这种指数级增长并非单纯依赖硬件晶体管密度的提升,而是源于模型算法、软件优化、计算架构、网络拓扑与内存子系统的深度协同设计。在运行 DeepSeek V4 Pro 模型等特定场景下,新架构能够使每百万 Token 的推理成本最高降低 45 倍。
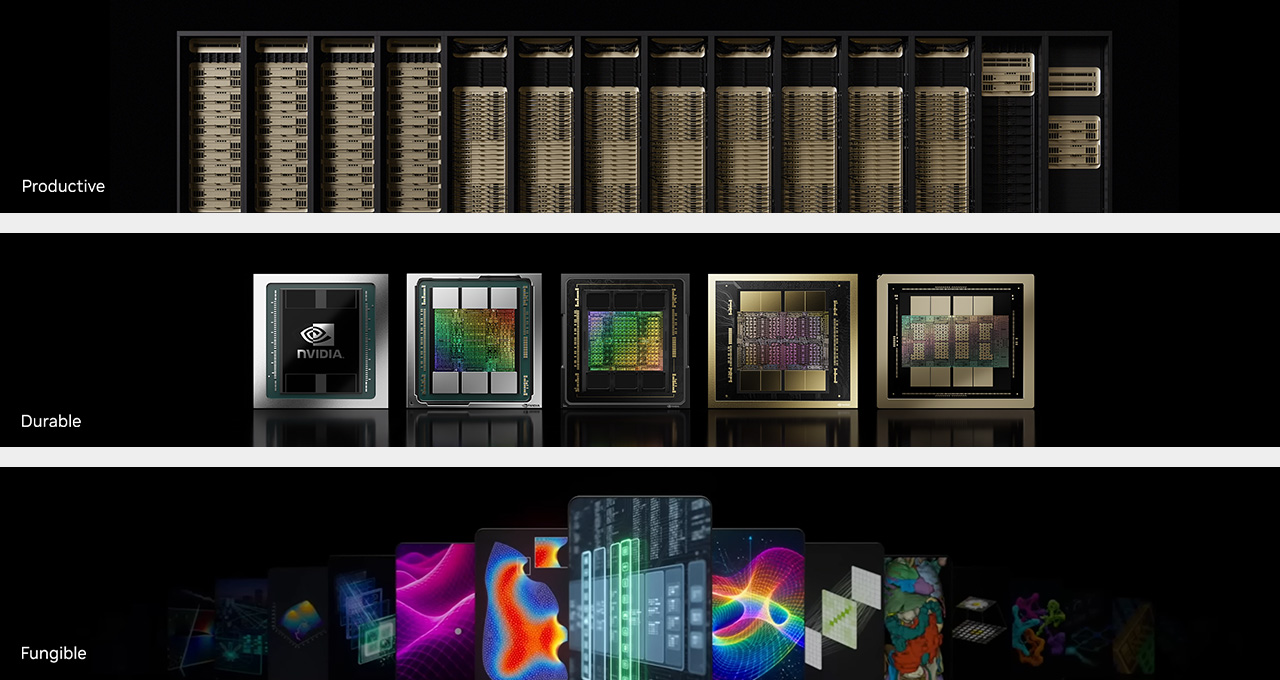
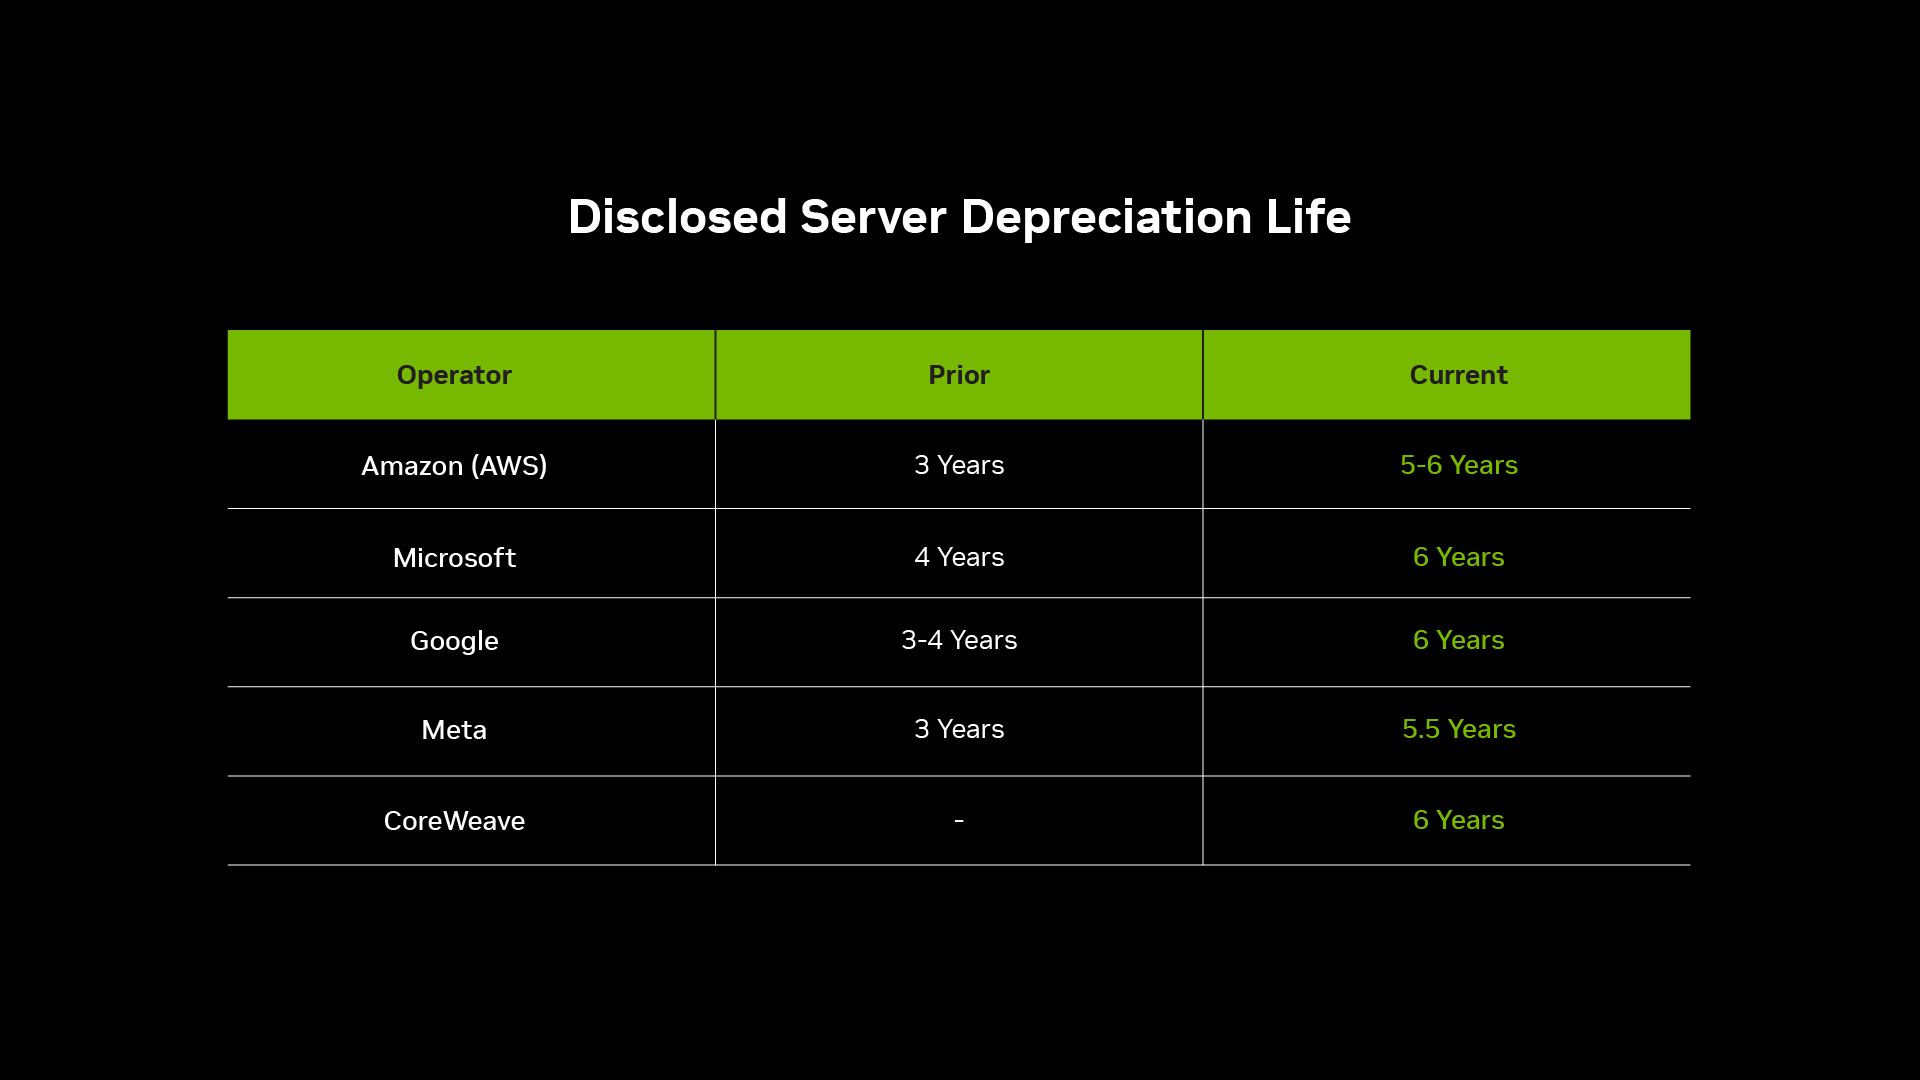
这种性能与成本的巨大差异对资产折旧和生命周期管理产生了深远影响。传统观点认为,随着新硬件发布,旧硬件价值会迅速归零,但 NVIDIA 的“可替代性”(Fungibility)理论指出,旧代系统在处理非实时性或对算力要求较低的推理负载时,依然具备极高的经济价值。以 2020 年发布的 A100 GPU 为例,尽管已运行多年,其商业服务能力未失效。云服务提供商 CoreWeave 甚至将 A100 的租赁合约延伸至 2029 年。研究机构 Ornn Data 的租赁市场分析表明,A100 在 5 年期合同中的租赁价格比 1 个月期合同高出 80%,这证明了长期稳定算力的市场溢价。同时,Silicon Data 的资产估值数据显示,即使是 6 年历史的 A100 集群,其残值仍可达到初始投资成本的 25%。另一家研究公司 Barkr 的预测模型估计,包含 8 个 GPU 的 H100 系统使用寿命为 5 至 6 年,而 GB300 NVL72 系统的寿命预计可达 9 至 10 年。这种长尾价值依赖于 CUDA 软件平台的跨代兼容性,确保新架构发布时,旧硬件不会沦为闲置资产,而是作为推理或多模态任务的补充算力层继续运转。
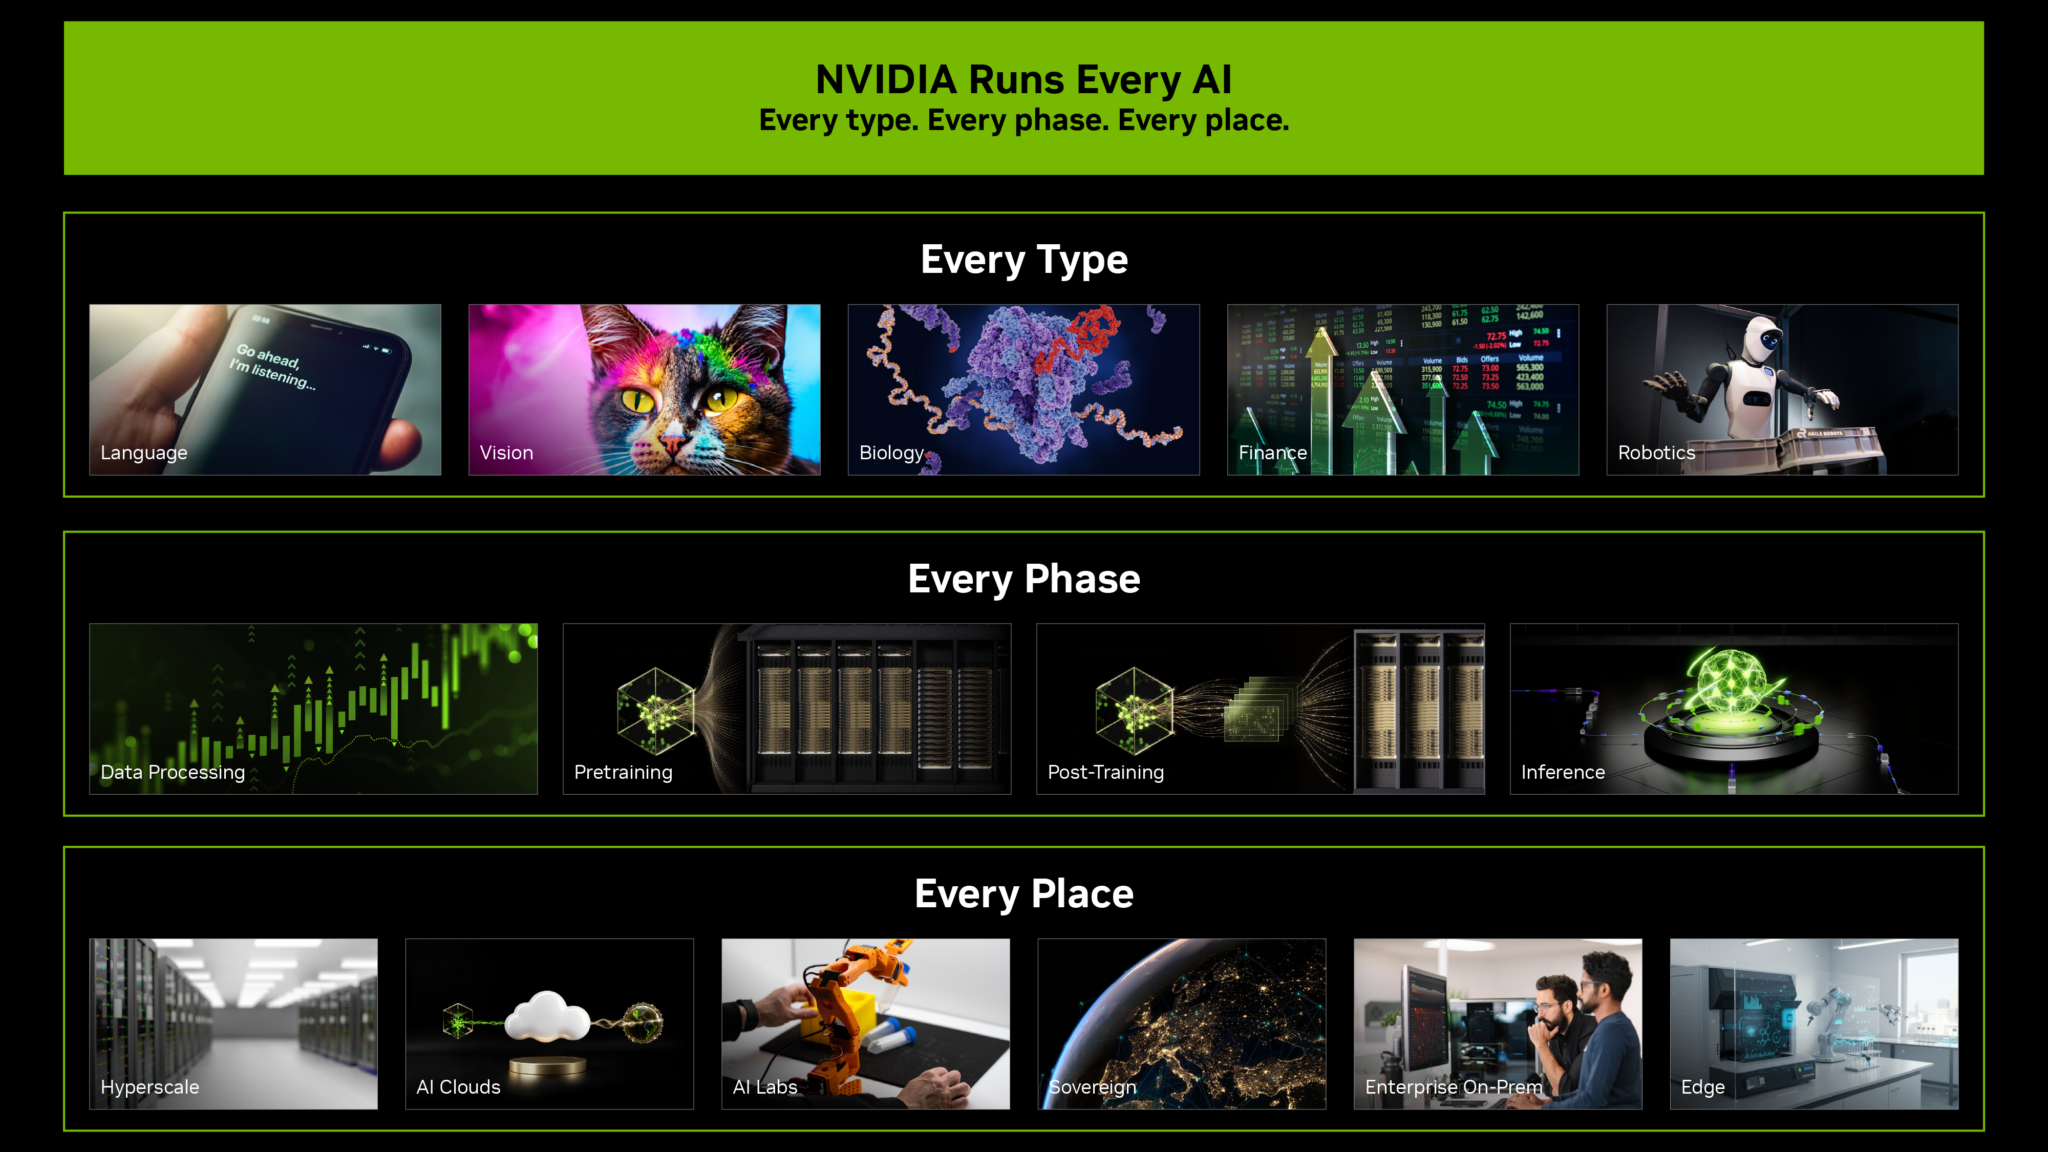
NVIDIA 的硬件并非针对单一负载定制的专用集成电路(ASIC),而是一种具备极高通用性的加速计算设备。其芯片内部集成了张量核心(Tensor Cores)和 Transformer 引擎,在保持可编程架构灵活性的同时,引入了针对 AI 优化的硬件单元。这种设计使得单一架构能够维持高利用率,支持从深度神经网络训练到物理 AI 模拟的广泛场景。CUDA-X 库作为关键软件资产,目前包含超过 1000 个预构建模块,覆盖计算光刻、量子电路模拟、向量搜索及气候建模等垂直领域,服务于全球超过 1000 万开发者。在实际应用层面,达索系统(Dassault Systèmes)利用该平台为威奇托州立大学(Wichita State University)提供飞机认证的虚拟孪生仿真支持,并为 Lucid Motors 的车辆设计流程提供算力。联合利华(Unilever)则利用数字孪生技术生成产品图像,替代了传统的实物摄影流程,使相关生产环节的成本降低了 50%。NVIDIA 创始人兼 CEO 黄仁勋(Jensen Huang)计划于 10 月 21 日星期三中午 11 时(中欧夏令时)在 GTC 柏林主题演讲中,深入阐述这一 AI 工厂体系如何平衡生产力、耐用性与可互换性。
影响分析
对于中文开发者与从业者而言,这一体系意味着基础设施采买的决策逻辑正发生根本性转变。过去,企业往往追求“顶配”算力以应对未来不确定的训练需求,导致资源闲置。而在 NVIDIA 提出的模型下,建立混合算力池成为更优策略:利用最新一代(如 Vera Rubin NVL72)硬件处理复杂的前沿模型训练与高吞吐推理,同时保留旧代(如 A100 或 H100)硬件处理成熟的生成式 AI 任务与科学计算。对于国内的大模型团队,这意味着在算力受限时,通过软件栈的跨代优化(CUDA 兼容性)挖掘存量硬件价值,比单纯等待新硬件更具成本效益。此外,超过 1000 个 CUDA-X 库的存在,降低了垂直行业(如气象、金融、制造)开发者调用底层算力的门槛,使得非 AI 专业背景的工程团队也能通过预构建模块快速部署数字孪生或仿真应用。这要求国内企业在进行数据中心建设时,需将“每兆瓦产出比”纳入核心 KPI,而非单纯看 GPU 数量,从而在电费高昂的约束下最大化 ROI。
适用边界
本分析结论主要适用于采用 NVIDIA 完整技术栈(硬件+CUDA 软件生态)的场景。对于采用其他架构(如 AMD、国产 GPU 或定制 ASIC)的基础设施,由于缺乏跨代兼容的软件库支持,旧硬件的残值与生命周期延长效果可能大打折扣。此外,“每兆瓦 6000 万美元”的成本模型基于当前电力价格与硬件集成度,若未来电力成本大幅波动或硬件集成度发生代际断裂,该成本基准需重新校准。在边缘计算或极端低功耗场景下,兆瓦级的建造单位不适用,该模型的有效性受限。
孤本观察
本文观察到,NVIDIA 正在试图将 AI 基础设施从“技术资产”重新定义为“金融资产”,通过延长折旧周期(如 A100 延至 2029 年)来平滑资本支出曲线。编辑认为,这种“耐用性”叙事不仅是技术宣称,更是为了对抗市场对于算力泡沫破裂的担忧,通过证明旧硬件仍有现金流,来增强投资者与租赁方对长期合约的信心。
常见问题
单个兆瓦规模的NVIDIA AI工厂建造成本约为多少?
约为6000万美元。
Vera Rubin NVL72系统每兆瓦吞吐量较GB300 NVL72提升了多少倍?
提升了超30倍。
6年历史的A100集群残值约为原成本的多少?
约为25%。
达索系统借助NVIDIA平台将部分产品生产成本降低了多少?
降低了50%。
来源:NVIDIA Blog