

一句话结论
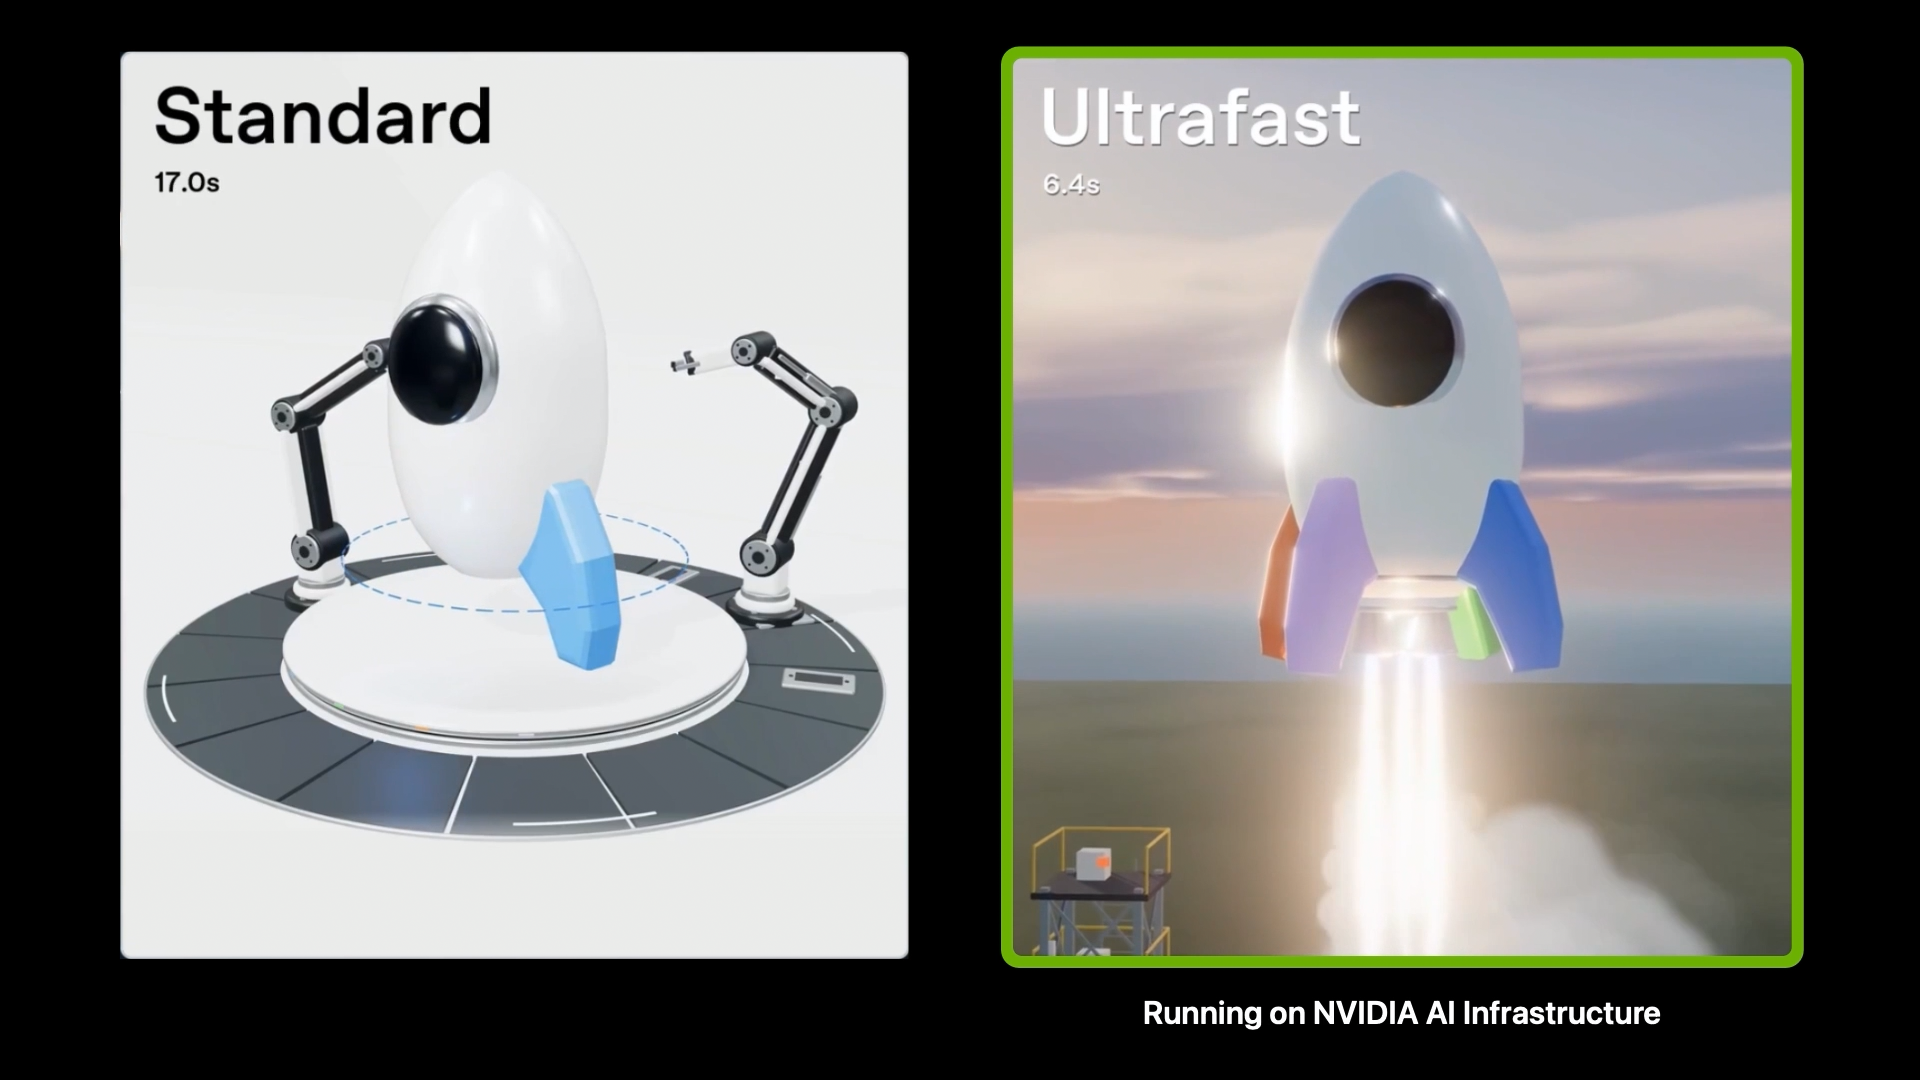
OpenAI 推出基于英伟达 Blackwell GPU 加速的 GPT-6 Astra Ultrafast 模式,实现最高 8 倍 Token 生成速度提升。
关键要点
- OpenAI 的 GPT-6 Astra Ultrafast 模式现已通过 OpenAI API 向符合条件的 ChatGPT Work 和 Codex 用户开放。
- 该模式利用英伟达 Blackwell 架构的推理优化能力,相比 Astra 标准模式,Token 生成速度最高提升 8 倍。
- 更快的生成速度缩短了编码智能体(Coding Agents)的“编辑-测试-调试”循环时间,并减少了工具调用之间的响应等待时长。
- OpenAI 利用自有模型优化在英伟达 GPU 上运行的推理软件,通过平台的可编程性持续测试并实施改进。
- 英伟达的可编程平台允许开发者在模型演进的各个阶段复用基础设施,支持训练、推理和强化学习等多元工作负载。
背景与事实
OpenAI 最近宣布,其新一代模型 GPT-6 Astra 的 Ultrafast(极速)模式已经上线。该模式运行在英伟达 Blackwell GPU 上,旨在通过深度利用硬件架构的推理优化能力,显著加速模型输出。目前,这项服务已向 OpenAI API 的订阅者以及符合条件的 ChatGPT Work 和 Codex 用户提供访问权限。
在性能表现方面,Ultrafast 模式的核心优势在于 Token 生成速度。与传统的标准模式相比,极速模式实现了高达 8 倍的生成速度提升。这种加速并非仅仅针对单次交互,而是着重于工作流中的重复性任务。例如,当智能体执行代码编写、调用外部工具、检查执行结果并决定下一步行动时,每一环节的响应延迟都会累积。Ultrafast 模式通过降低这些时间敏感型循环中的等待时间,使得复杂的代理任务执行更加流畅。
OpenAI 推理负责人 Philippe Tillet 指出,英伟达在工具链和文档方面的深度投入,使 OpenAI 的模型在编程 Blackwell 和 Rubin GPU 时表现出极高的效能。Tillet 表示,Astra 模型能够将这些知识转化为高性能的内核(Kernels),从而在延迟、吞吐量和成本的全谱系范围内展现英伟达硬件的竞争力。通过 Astra Ultrafast,这种硬件优势直接转化为在智能体编写代码、使用工具和解决复杂任务时的更快模型响应。
此外,OpenAI 计算首席技术官 Uday Ruddarraju 强调,与英伟达的合作正帮助 OpenAI 让 AI 变得更快且更有用。OpenAI 利用其内部模型优化了在英伟达 GPU 上运行的推理软件,而英伟达平台的可编程性则加速了这一过程。这种持续的工作意味着随着模型的迭代,部署的基础设施生产力也会随之提升,模型响应速度也会进一步优化。
影响分析
对于中文开发者与从业者而言,GPT-6 Astra Ultrafast 的推出具有显著的工程效率提升意义。明确认为,这种 8 倍的速度提升直接降低了智能体应用开发的迭代成本。在传统的编码智能体工作流中,等待模型生成代码或解析工具返回结果是主要的瓶颈之一。极速模式的引入,使得“编辑-测试-调试”这一核心循环的周转率大幅上升。这意味着开发者可以在相同的工作时间内完成更多的自动化任务,或者在更短的时间内验证代码逻辑的正确性。
从基础设施复用的角度来看,分析判断认为英伟达 Blackwell 和 Rubin 架构的可编程性为资源调度提供了更优解。对于企业级用户,这意味着不再需要为不同的工作负载(如预训练、微调、实时推理)维持完全隔离的硬件集群。通过利用 OpenAI 模型在推理软件层面的优化,企业可以更高效地复用计算资源,避免为每个特定任务过度配置硬件,从而在提升性能的同时控制总体拥有成本。这对于正在构建大规模 AI 应用系统的团队而言,是降低运营复杂度和硬件开支的重要技术路径。
适用边界
该结论主要适用于高度依赖大模型实时响应和复杂代理逻辑的场景,如自动化编码、多工具协同处理及交互式应用开发。对于单次简单查询或对延迟不敏感的批量离线处理任务,Ultrafast 模式带来的边际效益可能相对有限,且其定价策略可能与标准模式存在差异,开发者需根据实际业务场景对成本与速度的权衡进行评估。此外,该模式目前通过 OpenAI API 及特定 ChatGPT Work 和 Codex 渠道提供,未接入这些特定生态的产品或私有化部署环境可能无法直接获得同等程度的加速体验,除非自行在英伟达 Blackwell 硬件上复现类似的推理优化内核。
孤本观察
观察发现,OpenAI 正在将“模型即代码”(Model-as-Code)的理念延伸至硬件优化层面,即利用模型本身去优化底层 GPU 的推理内核,形成软硬协同的正反馈闭环。判断认为,这种基于英伟达可编程平台的持续优化机制,使得模型性能不再固化于发布时刻,而是随着基础设施软件栈的迭代动态演进,重新定义了大模型服务的生命周期管理方式。
常见问题
GPT-6 Astra Ultrafast模式最高可提升多少倍的Token生成速度?
相比Astra标准模式,该模式的Token生成速度最高提升8倍。
哪些用户可以通过OpenAI API访问GPT-6 Astra Ultrafast模式?
符合条件的ChatGPT Work用户和Codex用户可以通过OpenAI API访问该模式。
GPT-6 Astra Ultrafast主要适用于哪些对延迟敏感的场景?
适用于自动化编码、多工具协同处理、交互式应用开发等依赖实时响应和复杂代理逻辑的场景。
GPT-6 Astra Ultrafast基于哪种硬件架构实现推理加速?
该模式基于英伟达Blackwell架构实现推理加速,并利用其可编程性进行优化。
来源:NVIDIA Blog